DIE GESCHICHTE
Der Film, der es 1983 richtig zeigte
Ein Junge sitzt vor einem Heimcomputer. Er sucht den Rechner einer Spielefirma, weil er deren neue Spiele haben will, bevor sie im Laden stehen. Sein Modem wählt eine Telefonnummer nach der anderen. Bei einer meldet sich ein Rechner, der nicht sagt, wem er gehört, und eine Liste von Spielen anbietet, darunter Schach, Poker und etwas, das „Global Thermonuclear War“ heißt. Der Junge wählt den Atomkrieg und beginnt zu spielen.
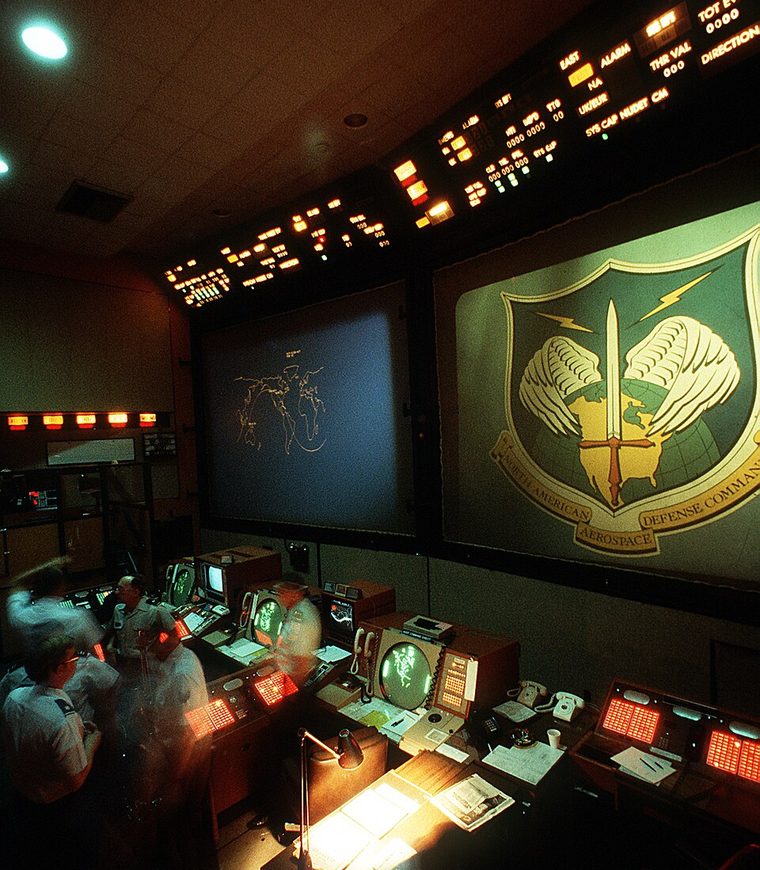
Der Rechner steht in Wirklichkeit bei NORAD, dem gemeinsamen Luft- und Weltraumverteidigungskommando der USA und Kanadas, und er hält das Spiel für einen echten Angriff. Auf den Lagekarten des Kommandozentrums erscheinen anfliegende sowjetische Raketen. Das Militär bereitet den Gegenschlag vor.
So beginnt „WarGames“, ein Film des Regisseurs John Badham aus dem Jahr 1983. Bekannt geblieben ist er wegen seines Schlusses.
Gebaut hat den Rechner der Forscher Stephen Falken. Die Maschine trägt das Kürzel WOPR, das Programm darin heißt Joshua, nach Falkens verstorbenem Sohn. Joshua gibt die Simulation nicht auf und sucht weiter nach dem Angriff, der sich gewinnen lässt. Falken und der Junge kommen auf einen Gedanken. Sie lassen die Maschine Tic-Tac-Toe spielen, nicht gegen einen Menschen, sondern gegen sich selbst.
Auf dem Bildschirm rasen die Partien vorbei, hunderte in Sekunden, und jede einzelne endet unentschieden. Danach spielt die Maschine ihre Kriegsszenarien durch, alle nacheinander, und findet dasselbe Ergebnis. Sie stellt die Simulation ein, nennt den Atomkrieg ein seltsames Spiel, in dem der einzige gewinnende Zug sei, nicht zu spielen, und schlägt eine Partie Schach vor.
Die Methode ist keine Erfindung des Drehbuchs. Die Maschine bekommt keinen Lehrer, keine Beispiele, keine Erklärung. Sie spielt gegen sich selbst und zieht daraus ihren Schluss. Das Verfahren gibt es wirklich, und es war 1983 bereits vierundzwanzig Jahre alt.
1959
Der Mann, der den Begriff prägte
Arthur Samuel kam 1949 in das Forschungslabor von IBM in Poughkeepsie, New York. Er beschäftigte sich mit Dame, im Englischen checkers, und zwar aus einem praktischen Grund. Das Spiel hat einfache Regeln und trotzdem zu viele Stellungen, um sie aufzuzählen. Wer es einer Maschine beibringen will, kann ihr die Antworten nicht vorlegen. Er muss die Maschine selbst darauf kommen lassen.
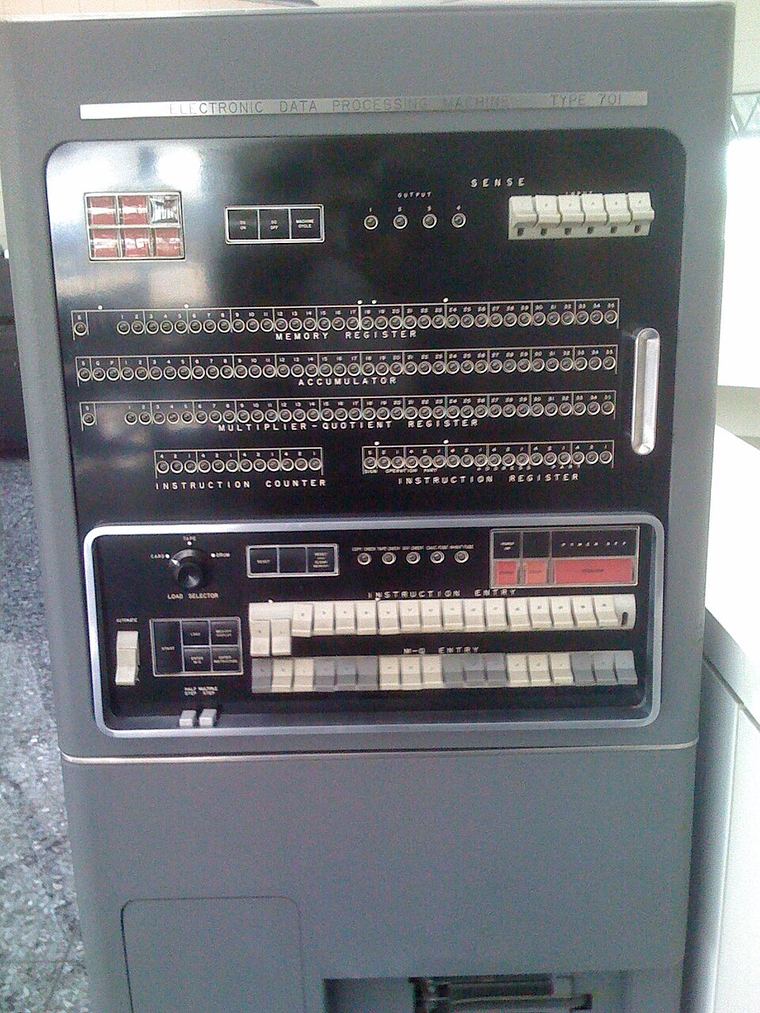

1952 lief die erste Fassung seines Programms auf der IBM 701, dem ersten serienmäßig gebauten Rechner des Unternehmens. Sie hielt sich an die Regeln und lernte nichts. Die erste lernende Fassung war 1955 fertig, ein Jahr später führte IBM sie im Fernsehen vor.
Im Juli 1959 veröffentlichte Samuel im IBM Journal of Research and Development einen Aufsatz mit dem Titel „Some Studies in Machine Learning Using the Game of Checkers“. Auf diese Arbeit geht der Begriff „machine learning“ zurück. Was heute eine ganze Branche bezeichnet, stand zuerst über einem Dame-Programm.
Samuels Programm bewertete jede Stellung mit einer Zahl. Die Zahl entstand aus einer Handvoll Eigenschaften, die er selbst ausgesucht hatte, etwa dem Steineübergewicht oder der Beweglichkeit, und jede Eigenschaft hatte eine Gewichtung. Diese Gewichtungen waren die einzigen Stellschrauben. Das Spielen selbst überließ Samuel einer gewöhnlichen Suche, die ein paar Züge vorausrechnete und die Stellung am Ende der Rechnung bewertete.
Wie ein Programm ohne Lehrer besser wird
Die eigentliche Frage war, woher die Gewichtungen kommen sollten. Samuel ließ das Programm gegen sich selbst antreten, in zwei Fassungen, die er Alpha und Beta nannte. Beta spielte mit den Gewichtungen, die sich bisher bewährt hatten. Alpha veränderte seine Gewichtungen während der Partie. Gewann Alpha, bekam Beta dessen Gewichtungen, und das Verfahren begann von vorn gegen den nun stärkeren Gegner.
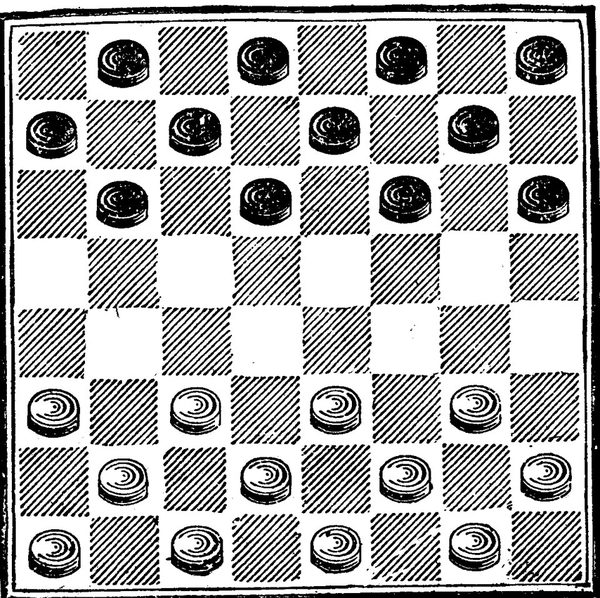
In diesen Partien steckt der Kern, der bis heute trägt. Ein Programm, das Dame spielt, erfährt erst am Schluss, ob es gewonnen hat. Für alle Züge davor bekommt es keine Rückmeldung. Samuel löste das mit einem Kunstgriff. Er verglich nicht die Bewertung mit dem Ausgang der Partie, sondern die Bewertung einer Stellung mit der Bewertung der nächsten.
Das Programm hält eine Stellung für ausgeglichen. Es zieht, und die neue Stellung sieht deutlich schlechter aus. Dann war die erste Einschätzung zu optimistisch, und das Programm korrigiert sie ein Stück nach unten.
Dieses Verfahren heißt heute Temporal Difference Learning, Lernen aus dem zeitlichen Unterschied. Samuel hat es nicht so genannt, er hat es benutzt.
Eines fehlte diesem Verfahren, und es sollte dreiunddreißig Jahre dauern, bis jemand es ergänzte. Der Ausgang der Partie spielte beim Lernen keine Rolle. Das Programm verglich immer nur seine eigenen Einschätzungen miteinander, und an keiner Stelle wurde eine davon an der Wirklichkeit gemessen.
Samuel sah selbst, worauf das hinausläuft. Eine Bewertung, die jeder Stellung denselben Wert gibt, widerspricht sich nie und taugt zu nichts. Er sicherte sich dagegen ab, indem er eine Größe festschrieb, an der das Programm nichts ändern durfte: das Übergewicht an Steinen. Trotzdem wurde es im ausgedehnten Selbstspiel zeitweise schlechter, und er musste von Hand eingreifen.
Samuel schrieb, sein Programm werde binnen acht bis zehn Stunden Maschinenzeit besser als der Mensch, der es geschrieben hat, und brauche dafür nichts weiter als die Spielregeln. Allerdings war Samuel selbst kein guter Dame-Spieler. Über das Niveau eines geschickten Anfängers kam auch sein Programm nicht hinaus.
Die Legende und was wirklich geschah

Berühmt wurde das Programm für etwas, das so nicht stattgefunden hat. 1962 spielte es gegen Robert Nealey und gewann. IBM kündigte Nealey in seiner Hauszeitschrift als früheren Dame-Meister des Staates Connecticut an und als einen der besten Spieler des Landes. Beides stimmte damals nicht. Den Titel in Connecticut gewann Nealey erst vier Jahre später, und an den großen Turnieren des Landes nahm er nicht teil.
Die Berichterstattung machte daraus, Dame sei für Menschen erledigt.
Ein Jahr später kam der Rückkampf, sechs Partien per Postkarte über mehr als fünf Monate. Das Programm verlor eine und spielte fünf unentschieden. 1965 nahm Samuel es mit zum Weltmeisterschaftskampf zwischen Walter Hellman und Derek Oldbury. Es spielte gegen beide je vier Partien und verlor alle acht.
Der historische Rang der Arbeit hängt an keiner dieser Partien. Er hängt daran, dass 1959 ein Programm existierte, das seine eigene Bewertung verbesserte, indem es gegen sich selbst spielte.
1992
Backgammon, und der Ausgang der Partie zählt endlich mit
Dreiunddreißig Jahre später saß Gerald Tesauro am Thomas J. Watson Research Center von IBM und wandte dasselbe Prinzip auf Backgammon an. Sein Programm hieß TD-Gammon, und das TD im Namen steht für genau jenes Lernen aus dem zeitlichen Unterschied, das Samuel benutzt hatte.

Neu war, worin die Bewertung steckte. Bei Samuel war sie eine Formel über Eigenschaften, die ein Mensch ausgesucht hatte. Bei Tesauro war sie ein neuronales Netz.
Ein solches Netz ist eine Rechenvorschrift in drei Lagen. Vorn steht die Stellung, also welcher Stein gerade wo liegt. Hinten steht eine einzige Zahl, nämlich die Gewinnaussicht. Dazwischen liegt eine Lage von Zwischenstellen, bei Tesauro achtzig Stück, und jede von ihnen verrechnet die Eingaben auf ihre eigene Art. Was diese achtzig Zwischenstellen beachten sollen, legte niemand fest. Sie bekamen am Anfang zufällige Werte, und das Lernverfahren schob sie so lange zurecht, bis sie nützlich wurden.
Das gilt für die mittlere Lage. Bei dem, was vorn hineingeht, probierte Tesauro zwei Wege. Ein Netz, das nur die nackte Stellung sah, erreichte allein durch Selbstspiel starkes Mittelmaß. Für die starken Fassungen legte er zusätzlich Merkmale an den Eingang, die er als Fachmann selbst entworfen hatte. Was das Netz in keinem Fall bekam, waren menschliche Partien oder Eröffnungswissen.
Und Tesauro ergänzte, was bei Samuel gefehlt hatte. Am Ende jeder Partie steht ein Ergebnis, das nicht geschätzt, sondern bekannt ist. Von dort aus korrigiert das Programm Zug für Zug rückwärts, und nach vielen Partien wirkt der Ausgang bis in die ersten Züge zurück.
Damit war die Bewertung an etwas gebunden, das nicht aus dem Programm selbst stammte. Bei Samuel musste diese Bindung von Hand kommen.
Das Programm spielte gegen sich selbst, korrigierte nach jedem Zug seine Einschätzung und wurde langsam besser. Sein öffentliches Debüt gab TD-Gammon 1992 beim World Cup of Backgammon. In achtunddreißig Partien gegen Spitzenspieler lag es am Ende nur sieben Punkte zurück.
Ein Jahr später hatte die nächste Fassung anderthalb Millionen Partien gegen sich selbst hinter sich. Sie spielte knapp unter dem Niveau der besten Menschen der Welt.
Wichtiger als die Spielstärke war eine Nebenwirkung. Bei bestimmten Eröffnungswürfen zogen Spitzenspieler seit dreißig Jahren denselben Zug, das sogenannte Slotting. TD-Gammon hielt einen anderen für besser. Der Backgammon-Meister Bill Robertie veröffentlichte die Rechnung des Programms 1992 in der Fachzeitschrift Inside Backgammon, Turnierspieler probierten den Zug aus und hatten Erfolg damit. Binnen weniger Jahre verschwand das Slotting aus dem Turnierspiel.
Eine Maschine, der niemand Eröffnungen beigebracht hatte, korrigierte das Lehrbuch.
2017
Go, und die zweite Zutat
Go galt fünfzig Jahre lang als das Spiel, an dem Programme scheitern. Das Brett hat 361 Schnittpunkte, auf denen ein Stein liegen kann. Daraus ergeben sich rund 10 hoch 170 erlaubte Stellungen, also mehr, als das beobachtbare Universum Atome hat. Gute Spieler beschreiben ihre Entscheidungen mit Wörtern wie Gefühl und Form.

Im Oktober 2017 erschien in der Zeitschrift Nature eine Arbeit mit dem Titel „Mastering the game of Go without human knowledge“. Das Programm hieß AlphaGo Zero, und das Zero im Namen bezeichnet den Umstand, dass es keine einzige menschliche Partie gesehen hatte. Es bekam die Regeln und sonst nichts.
Der Vorgänger hieß einfach AlphaGo und war anders vorgegangen. Er hatte zunächst aus hunderttausenden menschlichen Partien gelernt und erst danach gegen sich selbst gespielt. Im März 2016 schlug diese Fassung den Weltklassespieler Lee Sedol mit vier zu eins.
AlphaGo Zero hatte von alldem nichts gesehen. In drei Tagen spielte es 4,9 Millionen Partien gegen sich selbst, dann trat es gegen den Bezwinger von Lee Sedol an und gewann einhundert Partien zu null.
Es ist dasselbe Verfahren wie 1959. Ein Programm bewertet Stellungen, spielt gegen sich selbst und zieht jede Bewertung ein Stück in Richtung dessen, was danach tatsächlich passiert.
Unterschiedlich ist nur zweierlei. Das eine ist, worin die Bewertung steckt. Von Samuel über Tesauro bis zu AlphaGo Zero wurde sie immer größer und immer weniger von Hand entworfen.
Das andere ist die Rolle der Suche. Samuels Programm rechnete ein paar Züge voraus. TD-Gammon kam mit ein bis zwei Zügen aus. Bei Backgammon fällt zwischen zwei Zügen immer erst der Würfel, und die Rechnung muss jedes mögliche Ergebnis mitnehmen. Bei einundzwanzig Würfen und rund zwanzig Zügen je Wurf sind das schon nach einem Halbzug mehrere hundert Stellungen.
AlphaGo Zero verzahnte beides so eng, dass Bewertung und Suche sich gegenseitig hochzogen. Die Suche fand bessere Züge, als das Netz allein gefunden hätte, und das Netz lernte anschließend, diese besseren Züge selbst vorherzusagen.
Das gelernte Urteil sagt, welche Stellung gut aussieht. Die Suche prüft, ob dieser Eindruck den nächsten Zügen standhält.
Dazwischen: die Maschine auf dieser Seite
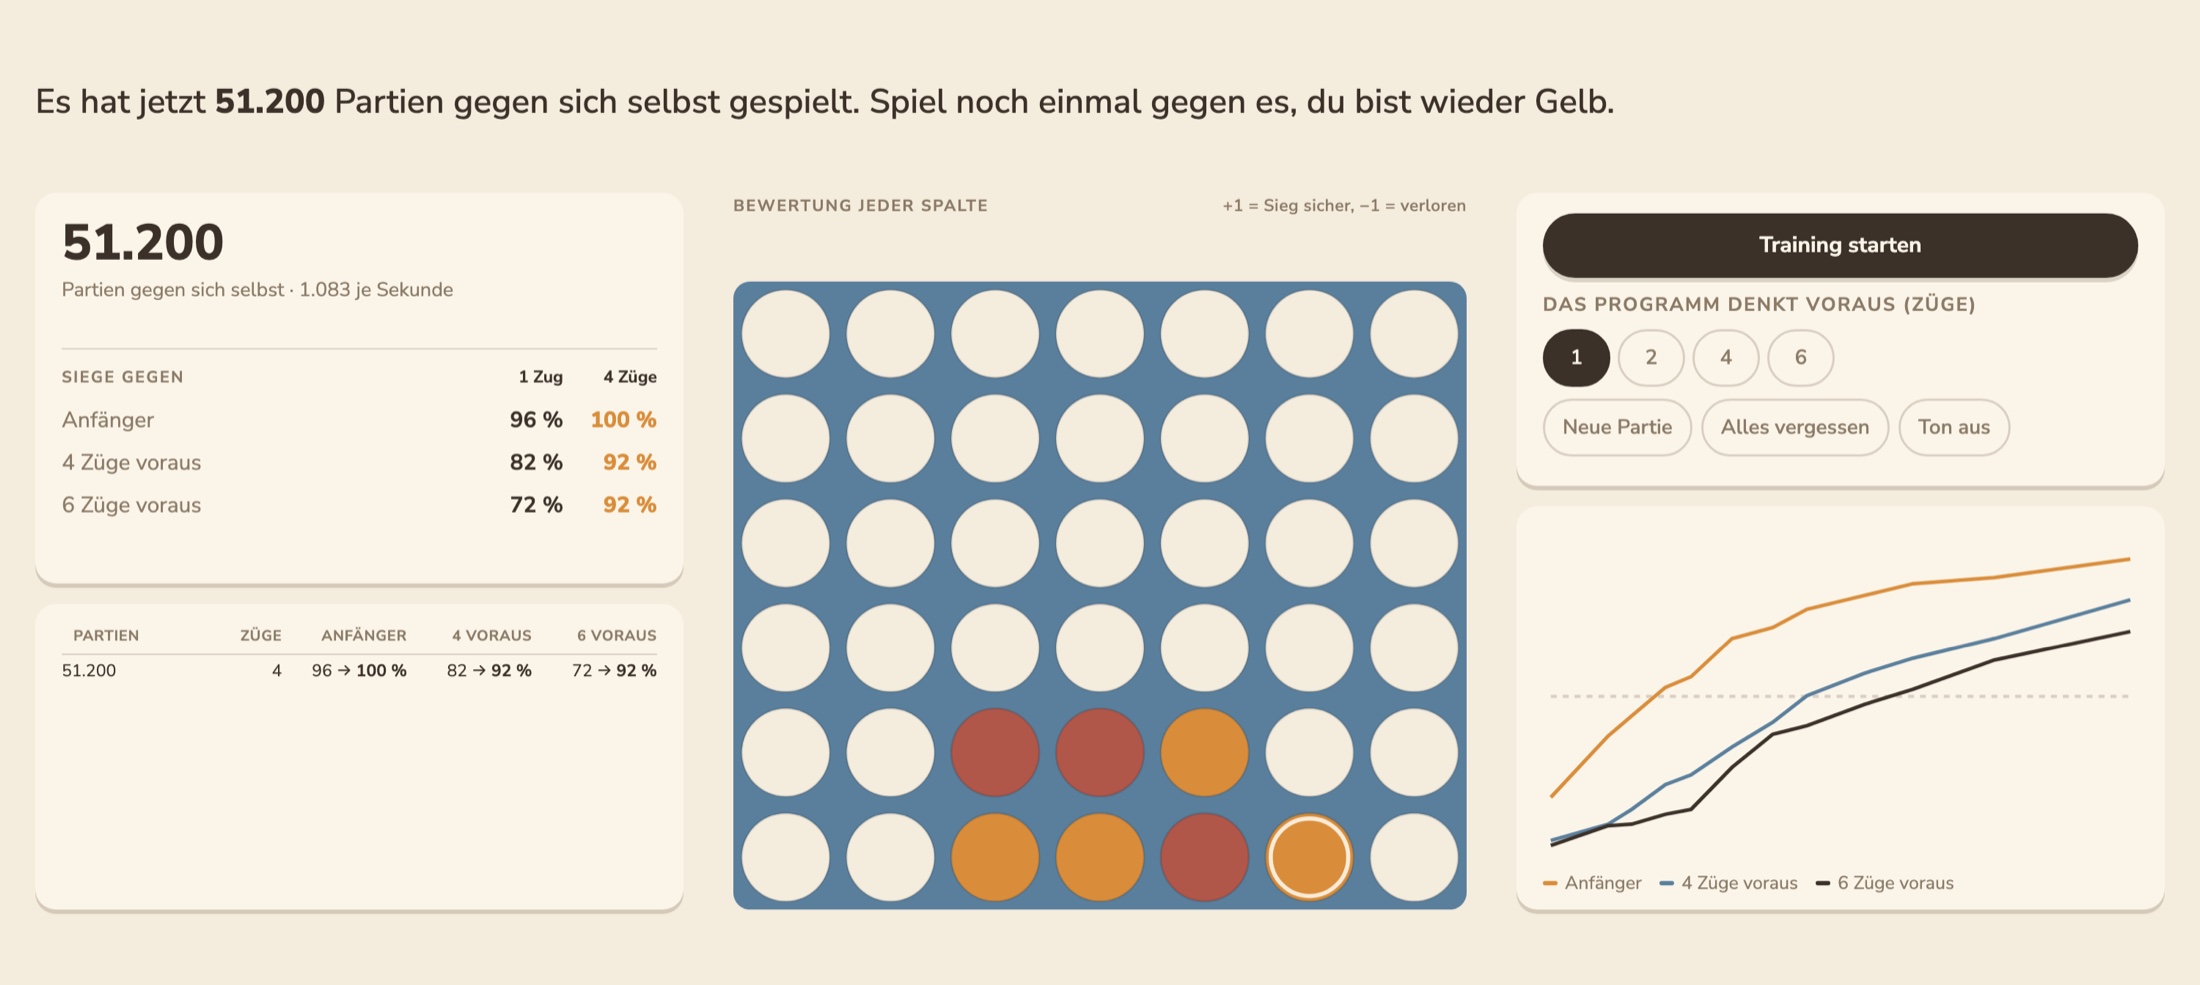
Auf dieser Seite steht ein Programm, das Vier gewinnt spielt. Es beginnt mit nichts als den Regeln. Es weiß nicht, dass die mittlere Spalte die stärkste ist, und es übersieht, wenn der Gegner drei Steine nebeneinander liegen hat. Ohne jede Erfahrung gewinnt es 7 von 100 Prüfpartien.

Dann drückt man auf „Training starten“, und das Programm spielt gegen sich selbst, ungefähr tausend Partien in der Sekunde. Nach einer Minute hat es rund fünfzigtausend Partien hinter sich und gewinnt 82 von 100 Prüfpartien. Wer jetzt noch einmal antritt, spielt gegen einen anderen Gegner als vorher. Das ist derselbe Vorgang wie bei Samuel, bei Tesauro und bei AlphaGo Zero, nur klein genug, um im Browser zu laufen.
Die Bewertung steckt in einem n-Tupel-Netz. Man kann sich das als siebzig Schablonen vorstellen, jede mit acht Gucklöchern. Jede Schablone liegt an einer festen Stelle auf dem Brett und sieht durch ihre acht Löcher immer nur diesen Ausschnitt. Für jedes Muster, das dort auftauchen kann, merkt sie sich eine Zahl. Die sagt, ob dieser Ausschnitt für Gelb spricht, für Rot, oder für keinen von beiden. Das Urteil über die ganze Stellung ist die Summe aus siebzig solchen Teilurteilen. Gelernt werden diese Zahlen mit dem Verfahren von Samuel und Tesauro, in einer Fassung, die jede Korrektur über acht Stellungen nach hinten verteilt.
Diese Bauform haben Markus Thill, Patrick Koch und Wolfgang Konen 2012 an der damaligen Fachhochschule Köln für genau dieses Spiel untersucht, zwei Jahre später zusammen mit Samineh Bagheri auch das Rückwirken über mehrere Stellungen.
Der Regler auf der Seite schaltet die zweite Zutat zu. Steht er auf einem Zug, entscheidet das Programm allein nach seinem gelernten Urteil, so wie es Tesauros erste Fassung tat. Schiebt man ihn auf sechs, rechnet es voraus und wendet sein Urteil erst am Ende der Rechnung an, wie AlphaGo. Man kann den Unterschied messen lassen, während man zusieht.
Was es kostet
An diesem Programm lässt sich eine Frage beantworten, die in den historischen Berichten meist fehlt: Wie viel bringt weiteres Training eigentlich noch?
Gemessen wurde an drei getrennten Trainingsläufen, geprüft gegen drei Testgegner unterschiedlicher Stärke, jeweils tausend Prüfpartien je Messpunkt.
| Partien gegen sich selbst | gewonnene Prüfpartien |
|---|---|
| keine | 7 von 100 |
| 3.000 | 31 von 100 |
| 10.000 | 57 von 100 |
| 50.000 | 82 von 100 |
| 100.000 | 86 von 100 |
| 300.000 | 91 von 100 |
Die ersten vierundzwanzig Punkte kosten dreitausend Partien. Die letzten fünf kosten zweihunderttausend. Das ist der Grund, warum jeder weitere Fortschritt mehr Rechenzeit verschlingt als der gesamte Fortschritt davor.
Diese Messung enthält allerdings eine Falle. Nach hunderttausend Partien gewinnt das Programm gegen seine Testgegner fast alles, und danach tut sich scheinbar nichts mehr. Wer nur so misst, würde schließen, es sei ausgelernt.
Gegen einen perfekt spielenden Gegner sieht dieselbe Strecke anders aus. Ein solcher Gegner lässt sich für Vier gewinnt bauen, weil das Spiel vollständig durchrechenbar ist. Gemessen wird dann nicht der Sieg, sondern die Fehlerquote: Wie oft wählt das Programm einen Zug, der das Ergebnis verschlechtert?
| Partien gegen sich selbst | Fehler je Zug |
|---|---|
| 10.000 | jeder sechste Zug |
| 100.000 | jeder siebzehnte |
| 500.000 | jeder siebenundvierzigste |
| 1.000.000 | jeder sechshundertste |
Genau dort, wo die schwachen Testgegner nichts mehr anzeigen, fällt die Fehlerquote noch einmal auf ein Fünfunddreißigstel. Flach wird nicht das Lernen, flach wird das Messgerät.
Das ist keine Feinheit für Statistiker. Wer beurteilen will, ob ein lernendes System noch besser wird, braucht einen Maßstab, der nicht vorher an seine Decke stößt.
Zurück zu WarGames

Die Methode stimmt. Eine Maschine, die Tic-Tac-Toe gegen sich selbst spielt, lernt tatsächlich in Sekunden, was dabei herauskommt. Das Spiel hat 5.478 erlaubte Stellungen, ein Programm rechnet sie vollständig durch, und das Ergebnis lautet: Bei richtigem Spiel endet jede Partie unentschieden. So weit ist der Film näher an der Sache als die meisten Darstellungen künstlicher Intelligenz, die danach gedreht wurden.
Der Schluss, den Joshua daraus zieht, stimmt nicht.
Ein Programm, das durch Selbstspiel lernt, wählt immer unter den Zügen, die die Regeln zulassen. Alles, was es überhaupt in Betracht ziehen kann, steht in diesem Verzeichnis erlaubter Züge. Der einzige gewinnende Zug, von dem der Film spricht, steht nicht darin. Nicht zu spielen ist kein Zug, er hat keine Bewertung, und er lässt sich nicht lernen. Was das Programm aus lauter Unentschieden tatsächlich lernt, ist etwas anderes: Alle Züge führen zum selben Ergebnis, also ist es gleichgültig, welchen es wählt. Aus dieser Gleichgültigkeit folgt kein Verzicht. Sie führt zu einem Programm, das weiterspielt und dabei mit den Schultern zuckt.
Der Sprung, den der Film macht, ist der Sprung von einer Zahl zu einer Haltung. Die Maschine bewertet den Atomkrieg mit null und beschließt daraufhin, ihn zu unterlassen. Dazwischen liegt eine Wertung, die niemand in sie hineingelegt hat. Sie lautet: Ein Ergebnis ohne Gewinner ist es nicht wert, angestrebt zu werden. Ein lernendes Programm zieht diesen Schluss nicht. Es optimiert das, wofür man es belohnt, und sonst nichts. Belohnt man Siege, lernt es siegen. Belohnt man nichts, weil es nichts zu gewinnen gibt, lernt es, dass alle Wege gleich sind.
Damit ist der Film an der entscheidenden Stelle tröstlicher als die Wirklichkeit. Er zeigt eine Maschine, die von selbst zur Vernunft kommt. Die Maschinen, die es wirklich gibt, kommen nicht zur Vernunft. Sie werden besser in genau dem, wofür man sie belohnt. Von allein hören sie damit nicht auf.
Das Programm auf dieser Seite spielt weiter, solange man es lässt. Es wird dabei immer besser darin, Vier gewinnt zu gewinnen. Es wird zu keinem Zeitpunkt auf den Gedanken kommen, dass es sich um ein Spiel handelt.
Woher die Angaben stammen
- Arthur L. Samuel: „Some Studies in Machine Learning Using the Game of Checkers“, IBM Journal of Research and Development, Juli 1959.
- Jonathan Schaeffer und andere, Universität Alberta: Darstellung zu Samuels Programm und zu den Partien von 1962 bis 1965.
- Gerald Tesauro: „Temporal Difference Learning and TD-Gammon“, Communications of the ACM, Band 38, Nr. 3, März 1995, sowie „TD-Gammon: A Self-Teaching Backgammon Program“.
- Bill Robertie: Analyse der Eröffnungszüge von TD-Gammon, Inside Backgammon 2:2, Seite 14 bis 22, 1992.
- Richard S. Sutton, Andrew G. Barto: „Reinforcement Learning. An Introduction“, Abschnitt zu Samuels Dame-Programm.
- David Silver und andere: „Mastering the game of Go without human knowledge“, Nature, Oktober 2017.
- Markus Thill, Patrick Koch, Wolfgang Konen: „Reinforcement Learning with N-tuples on the Game Connect-4“, 2012, sowie Markus Thill, Samineh Bagheri, Patrick Koch, Wolfgang Konen: „Temporal Difference Learning with Eligibility Traces for the Game Connect Four“, 2014.
- „WarGames“, Regie John Badham, 1983.
- Eigene Messungen zum Programm auf dieser Seite, September 2026.