Wie in fünfzehn Sekunden eine Bilderkennung entsteht
Sie haben der Maschine gerade zwei Dinge gezeigt, jedes fünf Sekunden lang, und danach konnte sie beide auseinanderhalten. Dazu kam das Bild ohne Ihre Objekte, damit sie weiß, wann keines davon zu sehen ist. Das ging schneller, als man es von künstlicher Intelligenz erwarten würde. Hier steht, warum. Und warum sie dabei manchmal etwas ganz anderes lernt, als Sie ihr zeigen wollten.
Das Vorbild stammt von Google. Die „Teachable Machine“ erschien 2017. Mit ihrer zweiten Fassung von 2019 haben Menschen in 201 Ländern bis 2020 über 125.000 eigene Erkennungen gebaut, für Bilder, Töne und Körperhaltungen. Diese Einheit übernimmt das Prinzip und zeigt zusätzlich, wonach die Maschine entscheidet. Alles rechnet in Ihrem Browser. Kein Kamerabild verlässt Ihren Rechner, und wenn Sie die Seite schließen, sind die Fotos weg.
Das meiste hat sie schon vorher gelernt
Aus fünfzig Fotos allein lernt kein neuronales Netz, was eine Tasse ist. So heißen die Rechenprogramme, die aus Beispielen lernen. Ein solches Netz müsste erst herausfinden, was eine Kante ist, eine Rundung, eine glänzende Fläche. Dafür braucht es Hunderttausende Bilder.
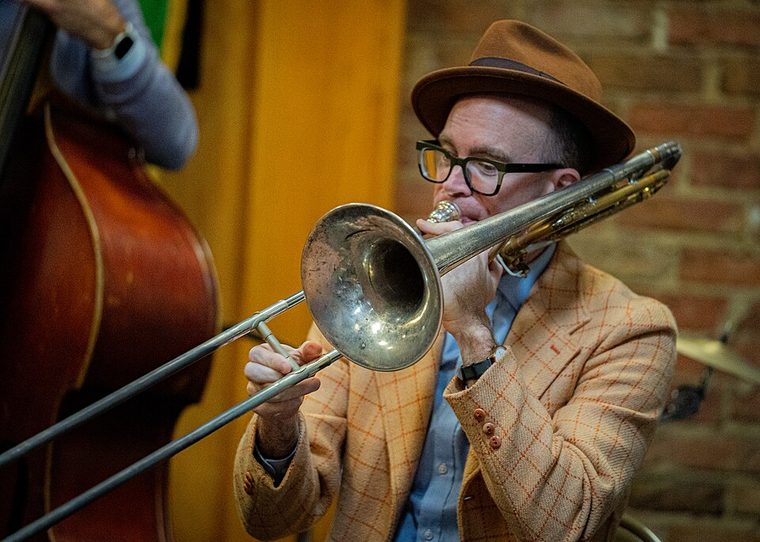
Diese Arbeit hat Google erledigt. Das Unternehmen hat 2018 ein Bildnetz namens MobileNet vorgestellt, das an 1,28 Millionen Fotos gelernt hat, 1.000 Dinge zu unterscheiden, darunter die Posaune und über hundert Hunderassen. Diese Fotosammlung heißt ImageNet, und an ihr messen sich solche Netze seit Jahren.
Hier läuft eine schlanke Fassung von MobileNet, dieselbe, die auch Googles Teachable Machine lädt. Sie ist 1,6 Megabyte groß und besteht aus 410.208 Zahlen. Die meisten davon sitzen in 52 Schichten, durch die jedes Bild nacheinander läuft. Ein fertiges Netz für eine neue Aufgabe weiterzuverwenden, heißt Transfer-Lernen.
Aus jedem Bild werden 1.280 Zahlen
Die Maschine nimmt aus jedem Kamerabild einen quadratischen Ausschnitt und verkleinert ihn auf 224 mal 224 Bildpunkte. Das Netz rechnet ihn durch seine Schichten und gibt am Ende 1.280 Zahlen aus. Die letzte Schicht, die daraus einen der 1.000 Namen machen würde, ist abgeschnitten. Übrig bleibt eine Beschreibung des Bildes, noch ohne Namen.
Man kann sich diese 1.280 Zahlen als Fingerabdruck des Bildes vorstellen. Zwei ähnliche Bilder haben ähnliche Fingerabdrücke. Was eine einzelne Zahl bedeutet, lässt sich nicht sagen. Keine steht einfach für „rund“ oder „rot“. Erst alle zusammen beschreiben das Bild.
Anlernen heißt hier nur Merken
Während der fünf Sekunden Aufnahme macht die Maschine zehn Fotos pro Sekunde, also fünfzig pro Objekt. Von jedem Foto speichert sie den Fingerabdruck und den Namen, den Sie vergeben haben. Das ist alles. Am Netz selbst ändert sich dabei keine einzige Zahl.
Deshalb geht es so schnell. Google trainiert in der Teachable Machine zusätzlich eine kleine Netzschicht, die aus den Fingerabdrücken eine Entscheidung macht. Diese Einheit verzichtet absichtlich darauf. Einer trainierten Schicht kann man nicht ansehen, wie sie entscheidet. Hier lässt sich jede Entscheidung nachvollziehen.
Die zehn ähnlichsten Fotos stimmen ab
Beim Raten macht die Maschine etwa achtmal pro Sekunde einen Fingerabdruck vom Kamerabild und vergleicht ihn mit allen gespeicherten. Heraus kommt für jedes Foto ein Wert zwischen null und hundert Prozent, je nachdem, wie gut die 1.280 Zahlen zueinander passen. Unter null fällt der Wert nie, weil keine der Zahlen negativ sein kann.
Dann stimmen die zehn ähnlichsten Fotos ab. Gehören sieben davon zur Tasse, steht die Tasse bei 70 Prozent. Die Prozentzahl zeigt also nur, wie die Stimmen verteilt sind. Man nennt das Verfahren „nächste Nachbarn“, weil die Fotos entscheiden, die dem Kamerabild am nächsten liegen. Laut sagt die Maschine erst etwas, wenn mindestens sieben der zehn übereinstimmen, und das mehrmals hintereinander.
Unter „Warum“ sehen Sie die drei ähnlichsten Fotos. Sie gehören zu den zehn, die tatsächlich abgestimmt haben.
Warum sie „keines“ erst lernen muss
Eine Antwort wie „Das kenne ich nicht“ hat die Maschine nicht. Sie findet immer zehn ähnlichste Fotos, auch wenn nichts Bekanntes im Bild ist, und nennt das Objekt, zu dem die meisten davon gehören. Ohne die Antwort „Keines der Objekte“ würde sie bei leerem Bild trotzdem Tasse oder Stift sagen.
Deshalb zeigen Sie ihr das leere Bild eigens. Danach kann sie „keines“ sagen, aber nur, weil sie auch das wie ein Objekt gelernt hat. Etwas Unbekanntes, etwa Ihr Telefon, landet trotzdem bei einer der gelernten Antworten.
Worauf sie wirklich achtet
Der Fingerabdruck beschreibt das ganze Bild, also auch alles um das Objekt herum. Eine Tasse füllt oft nur einen kleinen Teil des Ausschnitts, der Rest ist Wand, Fenster, Regal und Ihr Gesicht. Stand die Tasse beim Anlernen immer vor dem Fenster und der Stift immer vor der dunklen Wand, dann unterscheiden sich die Fotos auch im Hintergrund. Welcher Unterschied gemeint war, weiß die Maschine nicht. Halten Sie die Tasse danach vor die dunkle Wand, sagt sie womöglich „Stift“. Beim Ausprobieren dieser Einheit ist so etwas tatsächlich passiert. Je kleiner das Objekt im Bild ist, desto eher kommt es vor.
Ob sie auf den Hintergrund achtet, zeigt der Fokus der Maschine. Dafür wandert ein grauer Fleck, ein Sechzehntel des Bildes groß, nacheinander über 49 Stellen des Kamerabildes. Für jede Stelle rechnet die Maschine neu und misst, wie stark die Ähnlichkeit zu ihrer Antwort sinkt. Wo die Ähnlichkeit am stärksten sinkt, hat die Maschine hingeschaut, und dort erscheint die farbige Wolke. Liegt die Wolke auf dem Fenster statt auf der Tasse, wissen Sie, was sie gelernt hat.
In der Forschung heißt das „Shortcut Learning“, Lernen über eine Abkürzung. Die Maschine nimmt das Merkmal, das die Fotos am einfachsten trennt, ob es das gemeinte ist oder nicht.
Dasselbe bei großen Systemen
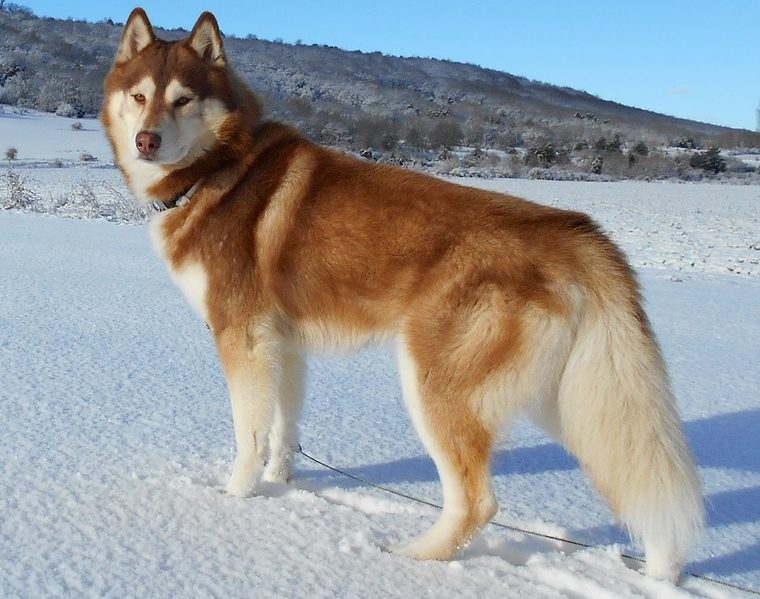

2016 hat ein Team um Marco Tulio Ribeiro so eine Abkürzung absichtlich gebaut. Eine Bilderkennung sollte Wölfe von Huskys unterscheiden. Die Forscher wählten die 20 Lernbilder so aus, dass alle Wölfe vor Schnee standen und kein Husky. Die Grundlage war, wie hier, ein vortrainiertes Bildnetz von Google. Heraus kam eine Erkennung für Schnee. Stand ein Husky im Schnee, hielt sie ihn für einen Wolf. Von 27 Testpersonen, alle mit Vorkenntnissen in maschinellem Lernen, hielten zehn die Erkennung für brauchbar, solange sie nur deren Antworten sahen. Nachdem sie gesehen hatten, auf welche Bildteile die Erkennung achtete, waren es noch drei.
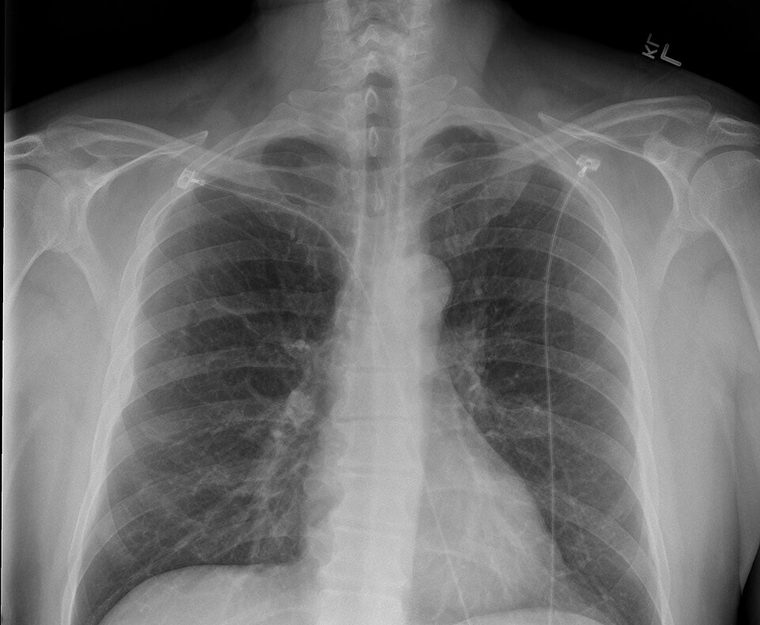

Ungewollt geschah dasselbe 2018 in der Medizin. Ein Team um John Zech und Eric Oermann trainierte Netze, die auf Röntgenbildern der Lunge eine Lungenentzündung erkennen sollten. Die Bilder kamen aus drei Klinikverbünden. In einem zeigte rund ein Drittel der Aufnahmen eine Lungenentzündung, in den beiden anderen jeweils etwa ein Prozent. Ein weiteres Netz, eigens auf die Herkunft trainiert, konnte an den Bildern ablesen, aus welchem Verbund sie stammten, und lag dabei fast immer richtig. Mit der Krankheit hatte das nichts zu tun. Das Netz achtete unter anderem auf kleine Metallmarken, die das Personal bei der Aufnahme in eine Ecke des Bildfelds legt. Die Herkunft eines Bildes verriet also schon viel über die Diagnose, und die Netze für die Lungenentzündung konnten diese Abkürzung nutzen. Auf Bildern aus einer fremden Klinik schnitten diese Netze in drei von fünf Vergleichen messbar schlechter ab.
Dagegen hilft Abwechslung beim Anlernen, hier genauso wie bei großen Systemen. Zeigen Sie die Tasse vor verschiedenen Hintergründen, bei anderem Licht, in der Hand und auf dem Tisch. Dann bleibt als Gemeinsamkeit aller Fotos nur noch die Tasse. Prüfen können Sie das mit dem Fokus. Die Wolke sollte dann auf der Tasse liegen und nicht auf dem Fenster.
Woher die Angaben stammen
- Carney, M. u. a.: „Teachable Machine: Approachable Web-Based Tool for Exploring Machine Learning Classification“, CHI 2020 Extended Abstracts. Daraus die Angaben zu Ländern und gebauten Modellen.
- Sandler, M. u. a.: „MobileNetV2: Inverted Residuals and Linear Bottlenecks“, CVPR 2018.
- Russakovsky, O. u. a.: „ImageNet Large Scale Visual Recognition Challenge“, International Journal of Computer Vision, 2015. Die Trainingsmenge umfasst 1.281.167 Fotos in 1.000 Kategorien.
- Ribeiro, M. T., Singh, S., Guestrin, C.: „‚Why Should I Trust You?‘ Explaining the Predictions of Any Classifier“, KDD 2016, Abschnitt 6.4.
- Zech, J. R. u. a.: „Variable generalization performance of a deep learning model to detect pneumonia in chest radiographs: A cross-sectional study“, PLOS Medicine, 2018.
- Geirhos, R. u. a.: „Shortcut learning in deep neural networks“, Nature Machine Intelligence, 2020.
- Zahl der Zahlen, Schichten und Dateigröße des Bildnetzes: eigene Zählung am ausgelieferten Modell, September 2026.