Ein Programm für genau eine Lage
In einer Montagehalle steht ein Mensch neben einem Industrieroboter und hält ein Programmierhandgerät in der Hand, einen Kasten mit Bildschirm, Tasten und einem Not-Halt-Schalter. Er fährt den Arm Achse für Achse an die Stelle, an der später ein Bauteil liegen wird, und speichert dort einen Punkt. Dann den nächsten, über dem Bauteil, dann einen über der Ablage. Zwischen die Punkte setzt er die Befehle zum Greifen und Loslassen. Danach fährt der Roboter die Folge ab, tausendfach und jedes Mal gleich.
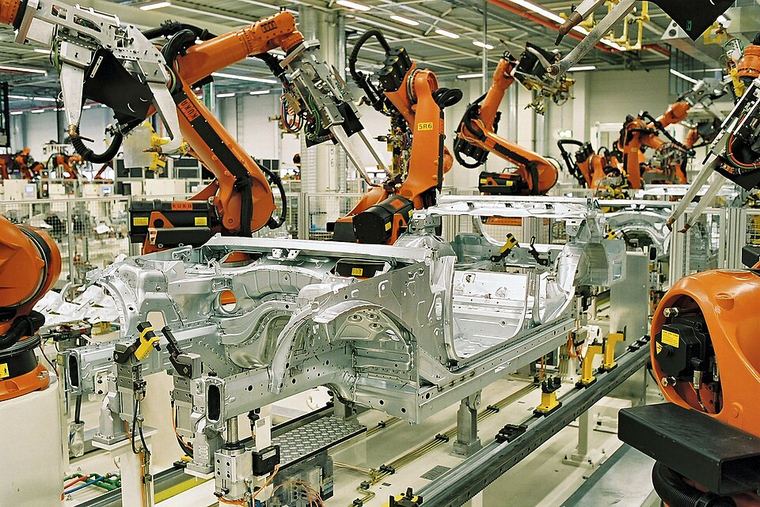

So werden bis heute viele der rund 4,7 Millionen Industrieroboter eingerichtet, die nach der Zählung des Branchenverbands International Federation of Robotics Ende 2024 weltweit in Betrieb waren. Allein 2024 kamen 542.000 hinzu. Die Methode heißt Teach-in. Sie ist zuverlässig, denn das Programm tut genau, was man ihm gezeigt hat.
Und sie hat eine Grenze, die sich nicht wegarbeiten lässt. Ein Programm aus gespeicherten Punkten setzt voraus, dass jedes Teil beim nächsten Mal dort liegt, wo es beim Einrichten lag. Deshalb stehen neben solchen Robotern Vorrichtungen, Anschläge und Förderbänder, die jedes Teil an denselben Platz bringen. Liegt ein Teil ein Stück daneben oder verdreht, greift die Zange ins Leere oder packt schief. Zengxi Pan, heute Professor für Industrierobotik an der University of Wollongong in Australien, stellte 2012 mit seinen Kollegen in einer Übersichtsarbeit fest, dass die schwierige Programmierung einer der Hauptgründe ist, warum kleine und mittlere Betriebe auf Roboter verzichten.

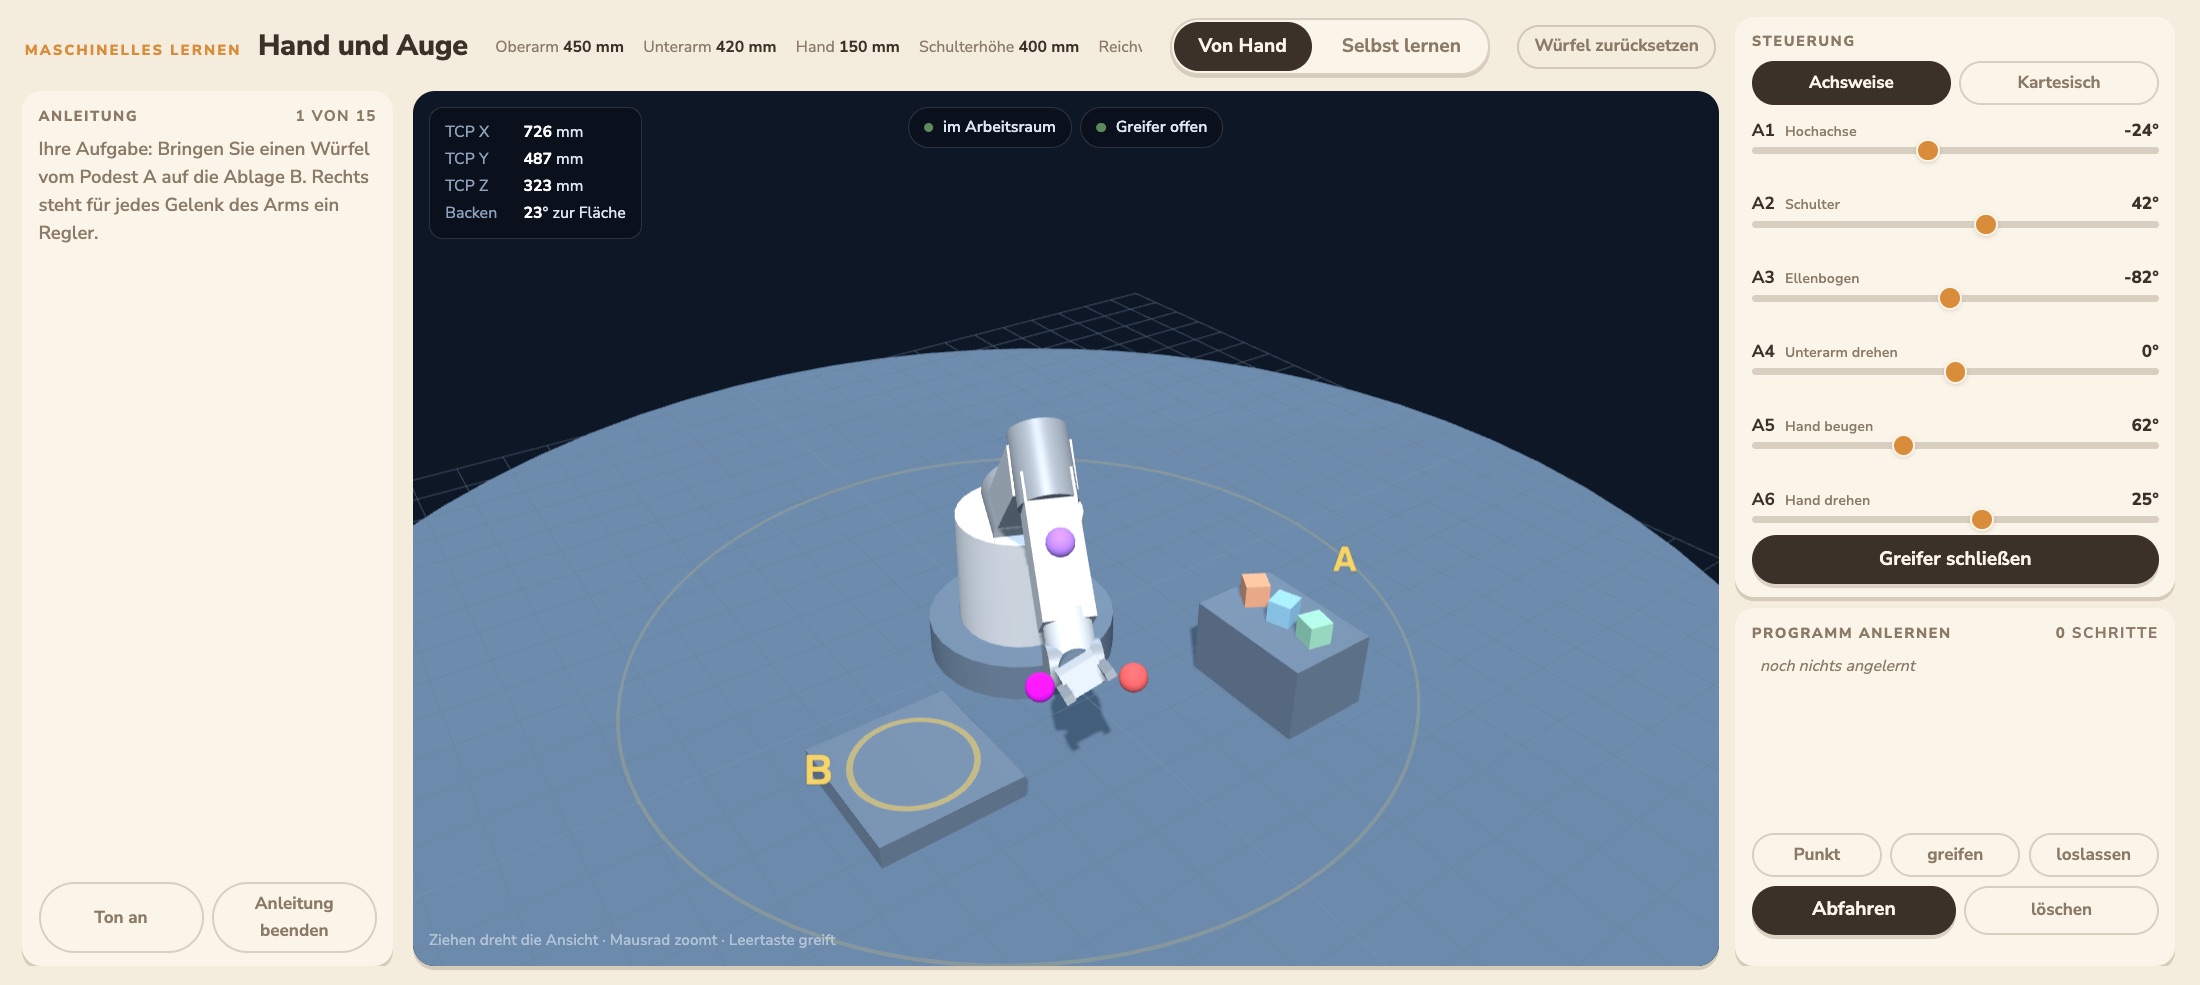
Im ersten Teil der Lerneinheit auf dieser Seite richtet der Besucher den Arm genau so ein, Punkt für Punkt mit Reglern. Der zweite Teil zeigt einen Arm, der ohne gespeicherte Punkte auskommt. Er sieht nach, wo die Würfel liegen, und holt sie.
Sehen, bevor man greift
Das Problem mit der Kamera
Soll ein Roboter Teile greifen, deren Lage nicht vorher feststeht, braucht er ein Auge. Eine Kamera über der Arbeitsfläche liefert ein Bild, in dem sich die Teile finden lassen. Ihre Lage im Bild ist damit bekannt, ihre Lage im Raum nicht. Zwischen Bildpunkt und Roboterkoordinate steht eine Umrechnung, die davon abhängt, wo die Kamera hängt, wie sie geneigt ist und welches Objektiv sie hat.
In der Industrie wird diese Umrechnung gemessen, bevor die Anlage läuft. Man spricht von Hand-Auge-Kalibrierung. Der Roboter fährt ein Kalibriermuster durch das Blickfeld, und aus den bekannten Stellungen und den gesehenen Mustern lässt sich zurückrechnen, wie Kamera und Arm zueinander stehen. Roger Tsai und Reimar Lenz, zwei Forscher am IBM-Forschungszentrum bei New York, beschrieben 1989 ein bis heute zitiertes Verfahren für den Fall, dass die Kamera am Greifer sitzt. Lenz forschte später an der Technischen Universität München weiter. Für eine fest montierte Kamera funktioniert das Verfahren ähnlich, mit einer eigenen Gleichung. Das Ergebnis stimmt so lange, bis jemand an die Kamera stößt.
Regeln, ohne zu kalibrieren
Die Regelungstechnik kennt einen zweiten Weg, der ohne vorherige Vermessung auskommt. Er heißt visuelles Regeln, im Englischen visual servoing. Der Robotikforscher Seth Hutchinson von der University of Illinois hat ihn 1996 gemeinsam mit Gregory Hager und dem Australier Peter Corke in einer vielzitierten Übersichtsarbeit zusammengefasst. Der Roboter bewegt sich, sieht nach, wie weit seine Hand im Bild noch vom Ziel entfernt ist, und bewegt sich wieder, bis der Abstand verschwindet.
Dafür muss er wissen, wie sich eine kleine Gelenkbewegung im Bild auswirkt. Diese Beziehung steckt in einer Matrix, der Bild-Jacobi-Matrix. Die Robotiker Koh Hosoda und Minoru Asada von der Universität Osaka zeigten 1994, dass man sie nicht kennen muss, sondern während der Bewegung aus Beobachtungen schätzen kann. Martin Jägersand und Randal Nelson von der University of Rochester prüften 1997 zusammen mit Olac Fuentes in Versuchen, wie genau sich so arbeiten lässt. Der Grundgedanke kehrt in allem wieder, was folgt. Man bewegt sich ein wenig, schaut, was sich im Bild ändert, und leitet daraus ab, wie man sich bewegen muss.
Lernen statt vermessen
Achthunderttausend Greifversuche
2016 ließ ein Team um den Informatiker Sergey Levine bei Google Roboterarme zwei Monate lang greifen, sechs bis vierzehn gleichzeitig, in Kisten voller unterschiedlicher Gegenstände. Dabei kamen mehr als 800.000 Greifversuche zusammen. Aus den Kamerabildern und dem Ausgang jedes Versuchs lernte ein neuronales Netz vorherzusagen, ob eine bestimmte Bewegung der Zange zu einem gelungenen Griff führt. Eine Kalibrierung der Kamera brauchte es dafür nicht.
In dieser Arbeit lernte das Netz die Beziehung zwischen Bild und Bewegung, nicht den Körper des Roboters. Die Zange griff stets senkrecht von oben. Gesteuert wurden eine Verschiebung im Raum und eine Drehung um die senkrechte Achse, und die Befehle gingen im Koordinatensystem des Roboters an dessen Steuerung. Seine eigene Mechanik kannte der Roboter also. Unbekannt waren das Verhältnis der Kamera zu ihm und die Frage, wie sich die Gegenstände greifen lassen.
Zwei Jahre später erreichte ein Team bei Google, zu dem wieder Levine gehörte, mit einem Verfahren namens QT-Opt nach mehr als 580.000 echten Greifversuchen 96 Prozent Erfolg bei Gegenständen, die das System vorher nie gesehen hatte. Methodisch war das ein Wechsel. Das Netz von 2016 hatte gelernt, den Erfolg eines einzelnen Griffs vorherzusagen. QT-Opt lernt mit bestärkendem Lernen, im Englischen reinforcement learning, eine Bewertung dafür, wie viel eine Bewegung zum späteren Erfolg beiträgt, und wählt danach Schritt für Schritt die nächste Bewegung.
Warum man in der Simulation übt
Achthunderttausend Versuche an echten Armen kosten Zeit, Aufsicht und Verschleiß, und jeder Fehlgriff kann etwas beschädigen. Deshalb verlagert die Forschung das Üben seit Jahren in Simulationen, in denen eine Physik-Engine Schwerkraft, Masse, Reibung und Stöße berechnet. Zu den verbreitetsten gehört MuJoCo, 2012 an der University of Washington von Emanuel Todorov und seinen Mitarbeitern Tom Erez und Yuval Tassa vorgestellt. Todorov erforschte dort, wie Menschen und Maschinen ihre Bewegungen steuern.

Die Simulation entspricht aber nie ganz der Wirklichkeit. Farben, Licht, Reibwerte und Massen weichen ab, und ein System, das nur die Simulation kennt, scheitert an diesen Unterschieden. Josh Tobin und seine Kollegen, darunter der Berkeley-Professor Pieter Abbeel, schlugen 2017 bei OpenAI einen Ausweg vor, der zunächst widersinnig klingt. OpenAI ist das Unternehmen, das später mit ChatGPT bekannt wurde. Die Forscher machten die Simulation absichtlich bunt und unrealistisch, mit zufälligen Texturen und Farben bei jedem Durchgang. Ein so trainierter Objektdetektor fand Gegenstände im echten Kamerabild auf 1,5 Zentimeter genau, obwohl er nie ein echtes Bild gesehen hatte. Die Autoren erklären das damit, dass die Wirklichkeit für ein solches Modell nur eine weitere Variante ist. Das Verfahren heißt Domain Randomization.
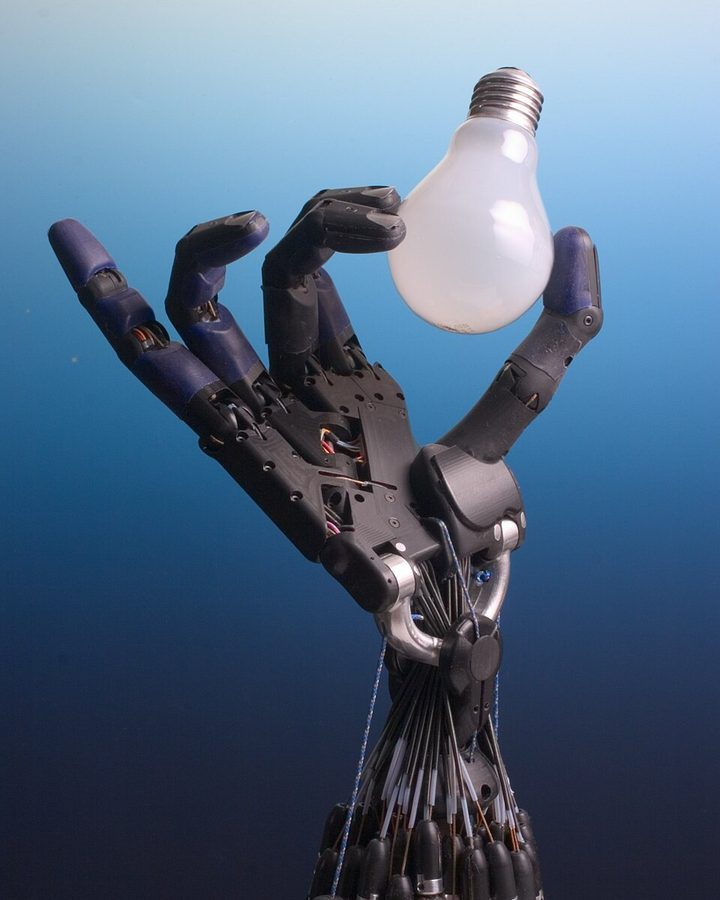
Wie weit sich das treiben lässt, zeigte OpenAI 2019. Eine Roboterhand mit fünf Fingern drehte einen Zauberwürfel, trainiert mit bestärkendem Lernen ausschließlich in der Simulation, deren Bedingungen während des Trainings immer stärker zufällig verändert wurden. Die angesammelte Übungszeit entsprach nach Angabe der Autoren rund 13.000 Jahren. Ihr bestes Ergebnis entspricht nach eigener Rechnung dem Lösen eines Würfels, der fünfzehn Drehungen braucht, in 60 Prozent der Versuche, und eines Würfels mit sechsundzwanzig Drehungen, dem schwierigsten Fall, in 20 Prozent.
Welche Seite als Nächstes zu drehen war, berechnete dabei ein klassisches Lösungsverfahren, das der deutsche Mathematiklehrer Herbert Kociemba 1992 entwickelt hatte. Das eigentliche Problem der Arbeit war nach den Worten der Autoren das Wahrnehmen und das Bewegen, nicht die Lösung des Würfels.
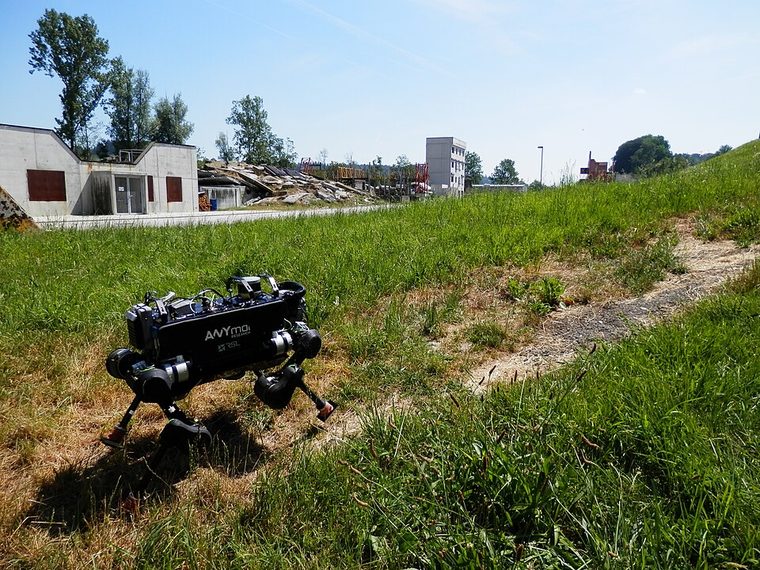

Seit Grafikkarten Tausende solcher Simulationen gleichzeitig rechnen, lassen sich manche Fähigkeiten in Minuten trainieren. Nikita Rudin und seine Kollegen von der ETH Zürich und vom Chiphersteller Nvidia ließen 2021 den vierbeinigen Roboter ANYmal in der Simulation mit bestärkendem Lernen laufen lernen, auf ebenem Boden in unter vier Minuten, auf unebenem in zwanzig. Das Ergebnis übertrugen sie auf den echten Roboter. ANYmal stammt aus dem Labor von Marco Hutter an der ETH, zu dessen Gruppe auch Rudin gehört.
Wo die Simulation nicht reicht
Schwer zu rechnen ist alles, was mit Berührung zu tun hat: Kontakt, Reibung zwischen Fingern und Gegenstand, nachgebendes Material. Amazon stellte 2025 einen Lagerroboter namens Vulcan vor, der mit Kraftsensoren spürt, wie fest er drückt und hält, und rund drei Viertel der Artikelarten im Lager greifen kann. Man habe Vulcan nicht einfach mit Computersimulationen anlernen können, schreibt das Unternehmen, und habe ihn deshalb mit Daten aus echter Berührung trainiert.
Einen anderen Weg gehen die großen Robotermodelle der letzten Jahre. RT-2 von Google DeepMind, der KI-Forschungsabteilung von Google, verbindet seit 2023 ein Bild-Sprach-Modell, das an Daten aus dem Internet gelernt hat, mit der Steuerung eines Roboters und gibt Bewegungen in derselben Form aus wie Wörter. Das Modell π0 von Physical Intelligence, einem 2024 gegründeten Unternehmen aus San Francisco, faltet Wäsche, räumt Tische ab und setzt Kartons zusammen. Vortrainiert wurde es mit mehr als 10.000 Stunden Roboterdaten, und für jede einzelne Aufgabe kamen nach Angabe der Autoren je nach Schwierigkeit 5 bis über 100 Stunden eigens gesammelter Vorführungen hinzu. Zu den Gründern von Physical Intelligence gehört Sergey Levine, derselbe, der 2016 die Greifversuche bei Google geleitet hat und heute zugleich Professor an der University of California in Berkeley ist. Solche Modelle lernen weitgehend den ganzen Weg vom Bild bis zur Bewegung, über viele Aufgaben hinweg, und brauchen dafür echte Daten in dieser Größenordnung. Nach heutigem Stand ergänzt die Simulation diese Daten, ersetzt sie aber nicht.
Ein Körper, der sich selbst findet
In den meisten dieser Arbeiten stellt sich eine Frage gar nicht, weil sie vorab beantwortet ist. Welcher Teil des Bildes bin ich selbst? Ein Säugling findet das heraus, indem er die Hände bewegt und ihnen zusieht.
Der Maschinenbauprofessor Hod Lipson untersucht mit seiner Arbeitsgruppe an der Columbia University in New York seit Jahren, ob Maschinen ein Modell ihres eigenen Körpers lernen können. 2019 ließ er mit seinem Mitarbeiter Robert Kwiatkowski einen Arm mit vier Gelenken zunächst zufällig umherfahren, rund tausend Bahnen mit je hundert Punkten. Nach weniger als 35 Stunden Training stimmte das gelernte Selbstmodell mit dem echten Arm auf etwa vier Zentimeter überein. Konnte der Arm seine Lage zwischen den Schritten anhand dieses Modells nachführen, legte er Gegenstände in 100 Prozent der Versuche in einen Behälter. Fuhr er die ganze Bewegung ohne jede Rückmeldung allein aus dem Modell heraus, gelang es in 44 Prozent. Als die Forscher ein verformtes Bauteil einsetzten, bemerkte der Arm die Veränderung und lernte sein Modell neu.
2022 gingen Boyuan Chen aus derselben Arbeitsgruppe und seine Mitautoren einen Schritt weiter. Ihr Roboter lernte aus Kamerabildern, welchen Raum sein ganzer Körper in jeder Stellung einnimmt. Seine Vorhersage lag auf etwa ein Prozent der Größe seines Arbeitsraums genau.
Die Lerneinheit greift nur den ersten, einfachsten Teil dieser Frage auf. Ihr Arm lernt kein Modell seines Körpers, sondern findet heraus, welche Flecken im Kamerabild zu ihm gehören.
Was die Lerneinheit davon zeigt
Die Welt, in der der Arm lernt
Die Lerneinheit auf dieser Seite läuft vollständig im Browser. Der Arm hat sechs Gelenke wie ein gewöhnlicher Industrieroboter, eine Schulterhöhe von 400 Millimetern und eine Reichweite von gut einem Meter. An Hand, Unterarm und Oberarm trägt er vier farbige Kugeln. Sie sind Markierungen, wie sie auch Anlagen zur Bewegungsmessung in Film und Sport verwenden. Der Arm selbst ist grau und blau lackiert, und die Kamera der Lerneinheit erkennt nur kräftig farbige Flecken. Ohne die Kugeln sähe sie den Arm gar nicht. Eine Kugel erscheint aus jeder Richtung als Kreis, und an der Hand sitzen zwei auf gegenüberliegenden Seiten, damit beim Drehen des Handgelenks fast immer eine zu sehen ist. Welche Farbe wohin gehört, sagt ihm allerdings niemand. Vor ihm liegen drei Würfel mit sechs Zentimetern Kantenlänge, jeder in einer anderen Farbe, und daneben steht eine Ablage mit einem Ring. Eine Physik-Engine berechnet Schwerkraft, Masse, Stöße und das Rutschen auf Flächen. Die Würfel kippen, wenn man sie anstößt, und bleiben liegen, wo sie hinfallen.
Die wichtigste Vereinfachung liegt genau dort, wo auch Amazon auf echte Daten zurückgreift. Das Greifen ist nicht bis in die Reibung zwischen Backen und Würfel gerechnet. Ein Würfel gilt als gegriffen und bewegt sich mit der Hand, wenn sein Mittelpunkt beim Schließen weniger als 48 Millimeter von der Greifstelle entfernt ist und die Backen höchstens zwölf Grad schräg zu seinen Flächen stehen. Ob diese Bedingungen erfüllt sind, muss der Arm selbst herausfinden. Auch die Kamera ist idealisiert, ohne Linsenverzeichnung und ohne Bildrauschen.
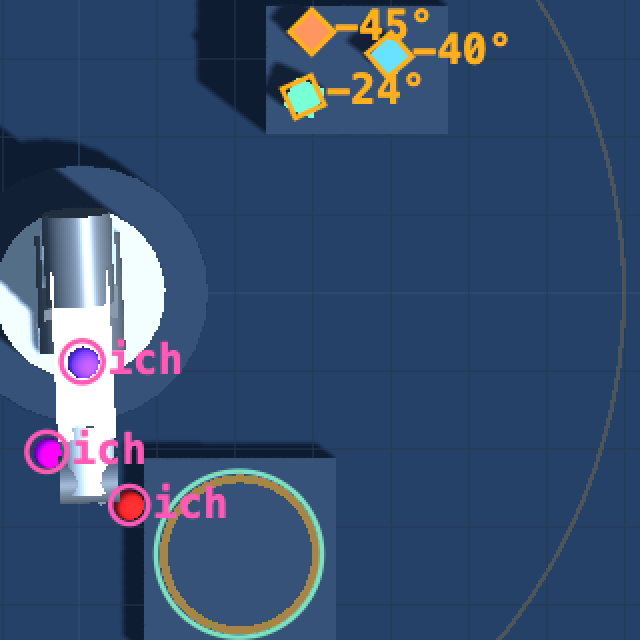
Diese Kamera hängt senkrecht über der Arbeitsfläche und bildet in Parallelprojektion ab, mit 320 mal 320 Bildpunkten, von denen jeder 3,75 Millimetern entspricht. Aus dem Bild sucht die Erkennung helle, farbige Flecken heraus und legt um jeden das kleinste umschließende Rechteck. Größe, Seitenverhältnis und Füllgrad entscheiden, ob es ein Würfel ist, ein Ring oder etwas anderes. Keine Koordinate und kein Name gelangen an den lernenden Teil, nur diese Flecken. Dazu kommen zwei einfache Sinne: eine Meldung, wenn die Hand an etwas stößt, wie sie der Kollisionsschutz eines echten Arms liefert, und ein Schalter zwischen den Backen, der anzeigt, ob etwas darin steckt.
Was eingebaut ist und was gelernt wird
Eingebaut ist, was jeder Industrieroboter ab Werk mitbringt, nämlich seine Mechanik. Die Steuerung weiß, welche Gelenkstellung die Hand an welchen Ort bringt, und sie hält die Hand senkrecht nach unten, wie in den Greifversuchen bei Google. Ebenfalls fest vorgegeben sind die Reihenfolge der Arbeitsschritte und die Schwellen der Bilderkennung. In diesen Schwellen steckt auch der Maßstab des Bildes. Wie groß ein Würfel im Bild erscheinen muss und wie weit ein Fehlblick danebenliegen darf, ist in Millimetern festgelegt.
Vorgegeben sind außerdem die Form jedes Modells und jede Regel für Sonderfälle. Welche Größen ein Modell hat, woran ein Fehlblick zu erkennen ist und wann eine Regel verworfen wird, hat der Entwickler festgelegt, meist nachdem eine Messung einen Fehler gezeigt hatte. Der Arm bestimmt die Zahlenwerte in diesen Modellen, also wie die Kamera zu ihm steht, wo seine Zange neben der verfolgten Kugel sitzt, wie hoch das Podest ist und bei welcher Einstellung ein Griff hält. Im engeren Sinn ist das Selbstkalibrierung, also das Bestimmen von Zahlenwerten aus eigenen Beobachtungen.
Die Lernschritte
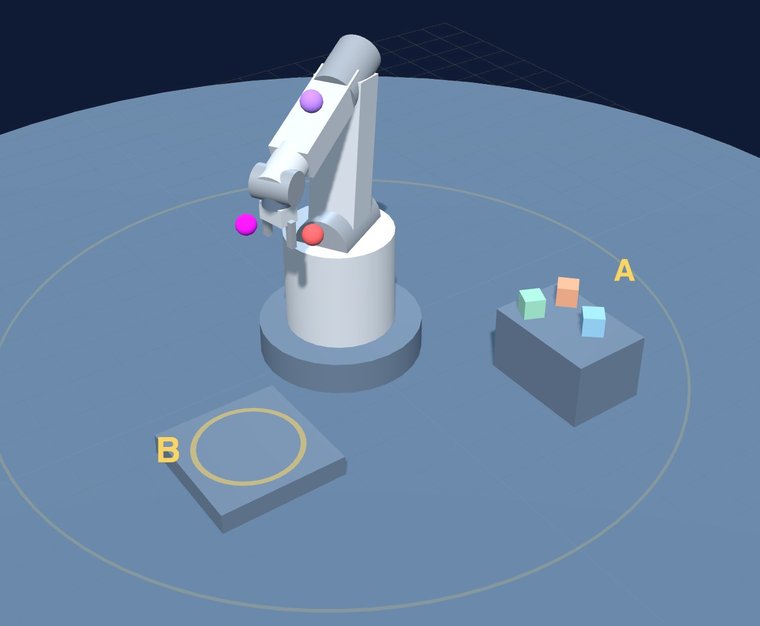
Sich selbst finden. Der Arm fährt zwölf zufällige Stellungen an und vergleicht die Bilder. Flecken, die in allen Bildern am selben Ort liegen, gehören nicht zu ihm. Was sich mitbewegt und in jedem Bild genau einmal vorkommt, ist er selbst. Der Fleck, der dabei am weitesten wandert, sitzt vermutlich an der Hand.
Die Kamera verstehen. Danach bewegt sich der Arm aufs Geratewohl, bis er 260 Beobachtungen gesammelt hat, in denen er seine Hand im Bild findet. Jede ist ein Paar aus der eigenen Handposition, die seine Steuerung kennt, und dem gesehenen Bildpunkt. Weil die Kamera parallel statt perspektivisch abbildet, ändert die Höhe der Hand nichts an ihrer Bildposition, nur die Lage in der Ebene zählt. Deshalb genügt eine lineare Abbildung mit sechs Größen, vier für Maßstab und Drehung und zwei für die Verschiebung, und die schätzt er mit einer Ausgleichsrechnung aus allen Beobachtungen zusammen. Das ist eine vereinfachte, ebene Form der Hand-Auge-Kalibrierung, hier nicht mit einem Muster vorab gemessen, sondern aus eigener Bewegung bestimmt. Von der Jacobi-Matrix bei Hosoda und Asada unterscheidet sie sich darin, dass sie Orte mit Bildpunkten verknüpft statt kleine Bewegungen mit kleinen Bildänderungen, und dass der Arm sie einmal für den ganzen Arbeitsraum schätzt statt fortlaufend neu. Auch für sie gilt, dass sie nicht mehr stimmt, wenn jemand an die Kamera stößt. Der Arm müsste dann von vorn lernen, bräuchte dafür aber kein Kalibriermuster. Geprüft wurde dieser Fall nicht.
Auge und Zange auseinanderhalten. Die Kugel, die der Arm im Bild verfolgt, sitzt nicht dort, wo die Zange greift, sondern rund neun Zentimeter daneben. Dreht er das Handgelenk, kreist sie um die Greifstelle. Zur Lage in der Ebene kommt hier also die Drehung der Hand hinzu. Ein Punkt auf einem Kreis lässt sich durch Kosinus und Sinus seines Drehwinkels beschreiben. Das Modell, das vorhersagt, wo die Kugel im Bild erscheint, hat deshalb je Bildrichtung fünf Größen: einen festen Anteil, zwei für den Ort der Hand und zwei für Kosinus und Sinus des Drehwinkels. Beobachtungen, die mehr als das Dreifache des typischen Fehlers danebenliegen, verwirft er als Fehlblicke, allerdings nie mehr als ein Drittel aller Beobachtungen. Geht die Rechnung trotzdem nicht auf, prüft er seine anderen Kugeln und wechselt, wenn eine besser passt. Diese Regel kam hinzu, weil er sich in neun von vierzig Entwicklungsläufen zunächst die Kugel am Unterarm als Hand gemerkt hatte, und ein Punkt am Unterarm kreist nicht um die Zange.
Die Höhe ertasten. Weil die Kamera von oben sieht, zeigt sie keine Höhe. Wie hoch das Podest mit den Würfeln ist, findet der Arm heraus, indem er die Hand senkt, bis sie anstößt. Die Höhe merkt er sich für die folgenden Teile.
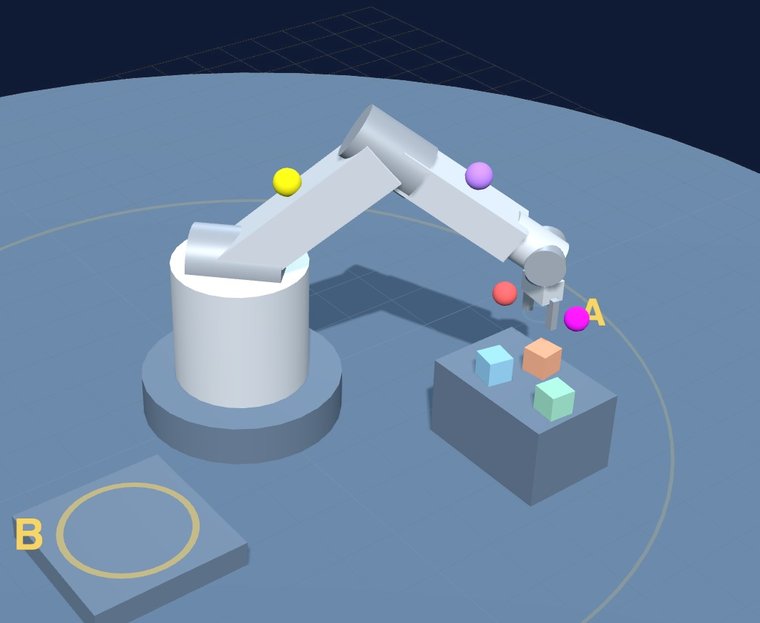
Zufassen. Wie weit über der Stelle, an der seine Hand auf dem Würfel aufsetzt, die Zange schließen muss und wie die Backen zur gesehenen Kante stehen müssen, rechnet er nicht aus. Er probiert es, hebt an und prüft über den Schalter zwischen den Backen, ob etwas darin steckt. Was hält, merkt er sich. Scheitert eine gemerkte Einstellung zweimal hintereinander, verwirft er sie und sucht neu. Auch diese Regel kam erst nach einer Messung hinzu. Vorher hatte der Arm am zweiten Würfel achtmal hintereinander mit exakt derselben falschen Backenstellung zugegriffen.
Ablegen. Den Ring, in den die Würfel sollen, erkennt er an seiner Form. Liegt dort schon ein Würfel, setzt er den nächsten im Ring daneben ab.
Was dabei herauskommt
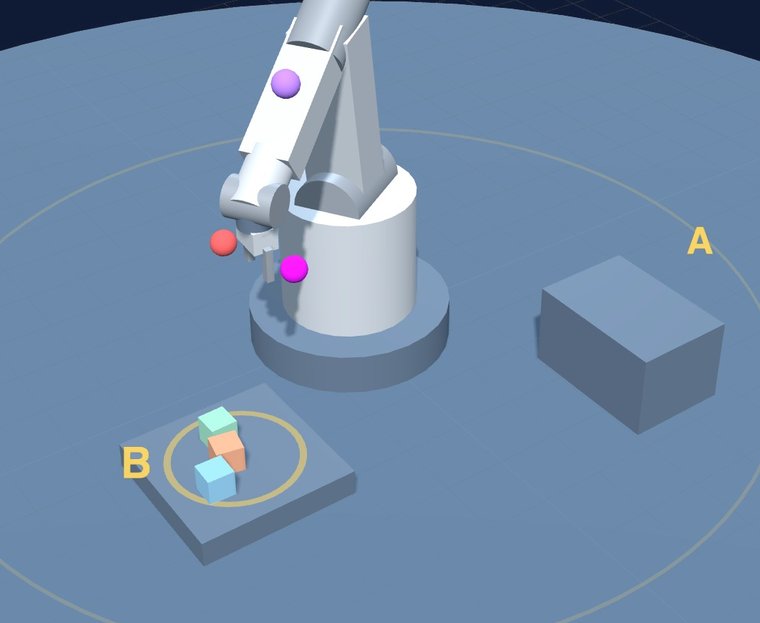
Gemessen wurde mit der endgültigen Fassung in zwölf Durchläufen, jeder mit einem frisch startenden Arm, der sein Modell neu lernte, und mit drei zufällig gedrehten, zufällig verteilten Würfeln. Der Arm legte alle 36 Würfel im Ring ab. Anschließend wurden in jedem der zwölf Durchläufe die Würfel dreimal neu gemischt, und der Arm holte sie, ohne eine einzige neue Beobachtung zu sammeln. Er legte 108 von 108 Würfeln ab. Ging ein Griff daneben, versuchte er es an demselben Würfel erneut. Wie oft das vorkam, wurde bei dieser Messung nicht gezählt, in einer früheren Messreihe über 24 Durchläufe waren es im Mittel 1,3 Versuche je Griff.
Diese Zahlen sind mit Vorsicht zu lesen. Die 108 Griffe beruhen auf nur zwölf gelernten Modellen, und null Ausfälle in zwölf Läufen schließen nach der üblichen statistischen Faustregel eine Ausfallquote von bis zu etwa einem Viertel je Lauf nicht aus. Die Hand kam meist drei bis sechs Millimeter neben der angesteuerten Stelle an, während die Greifbedingung 48 Millimeter Spielraum lässt. Und die Regeln des Arms wurden an ähnlichen Durchläufen entwickelt. Die Messläufe verwenden neue Zufallsszenen, sind aber kein unabhängiger Test im strengen Sinn.
Den Unterschied zum Programm aus dem ersten Teil macht vor allem das Sehen. Ein von Hand eingerichtetes Programm, das keine Kamera hat, hätte an den neu gemischten Lagen fast immer vorbeigegriffen. Nachgerechnet mit denselben Greifbedingungen, über zweihunderttausend zufällige Mischungen, läge nach dem Mischen in 37 Prozent der Fälle noch ein Würfel nah genug an der gespeicherten Greifstelle, aber nur in 10 Prozent stünde er auch so gedreht, dass der Griff hält. Ein klassisch eingerichteter Roboter mit derselben Kamera und vorab vermessener Kalibrierung würde in dieser idealisierten Welt vermutlich ebenso zuverlässig greifen, gemessen wurde das nicht. Was das Lernen beiträgt, ist etwas anderes. Der Arm bestimmt seine Kamerabeziehung, den Versatz seiner Zange, die Höhe des Podests und die richtige Art zuzufassen selbst, ohne Kalibriermuster und ohne dass jemand etwas ausmisst.
Aufschlussreich war ein Fehler, den erst das wiederholte Holen sichtbar machte. In einer früheren Fassung fehlte in zwei von acht Durchläufen bei jedem neuen Mischen derselbe Würfel, der orangefarbene. Der Arm hatte ihn beim ersten Umherbewegen angestoßen, der Würfel war ein Stück gewandert, und weil er sich zu bewegen schien, landete seine Farbe in der Liste der eigenen Farben. Beim späteren Suchen nach Würfeln sortierte der Arm alles aus, was eine seiner Farben trug, und damit auch diesen Würfel, in jedem weiteren Durchgang. Behoben ist das durch eine Bewegungsprobe beim Suchen selbst. Der Arm schaut dreimal hin und bewegt sich dazwischen ein wenig, und was dabei liegen bleibt, kann nicht zu ihm gehören, gleich welche Farbe es trägt. Um die neue Regel zu prüfen, wurde die Farbe des orangefarbenen Würfels nach dem Anlernen absichtlich in seine Liste geschrieben. So holte der Arm in 58 Durchgängen 172 von 174 Würfeln. Woran die zwei fehlenden scheiterten, ließ sich nicht nachstellen. Mit der alten Regel waren es in zehn Durchgängen 20 von 30, was nur zeigt, dass die Probe den Fehler zuverlässig auslöst.
Welche Art von Lernen das ist
Auf dieser Website stehen mehrere lernende Maschinen, und sie lernen auf sehr verschiedene Weise.
Das Perceptron auf dieser Seite, ein Nachbau des Perceptron Mark I von 1960, lernt mit Lehrer. Es bekommt ein Bild, gibt sein Urteil ab und erfährt sofort, ob es richtig lag. Jeder Fehler verstellt seine Gewichtungen ein Stück. Die richtige Antwort liegt für jedes Beispiel vor.
Ein Programm, das hier Vier gewinnt spielt, hat keinen Lehrer. Es spielt gegen sich selbst und erfährt erst am Ende einer Partie, ob es gewonnen hat. Daraus lernt es, Stellungen zu bewerten. Das ist bestärkendes Lernen in seiner klassischen Form. Seine Welt kennt es dabei vollständig, 42 Felder, sieben mögliche Züge, und jeder Zug gelingt. Im Browser schafft es rund 50.000 Partien in einer Minute.
Ein Sprachmodell lernt, das nächste Wort vorherzusagen. Der Lehrer steckt im Text selbst, denn das richtige nächste Wort steht jeweils schon da. Dafür braucht es Textmengen, die kein Mensch je lesen könnte.
Der Roboterarm hat keinen Lehrer, der ihm die richtige Bewegung vorgibt, und keinen Punktestand für die ganze Aufgabe. Er bekommt die Folgen seiner eigenen Bewegungen zurück, also wohin ein Fleck im Bild wandert, wann die Hand anstößt und ob der Schalter zwischen den Backen etwas meldet. Lernen aus solchen selbst erzeugten Beobachtungen heißt in der Robotik selbstüberwacht. Beim Greifen kommt Versuch und Irrtum hinzu, mit dem Schalter als Erfolgsmeldung für den einzelnen Griff. Das ist dem bestärkenden Lernen verwandt, nur ohne gelernte Bewertung, denn der Arm merkt sich einfach die Einstellung, die gehalten hat. Ein neuronales Netz steckt nicht darin. Die Modelle des Arms sind Ausgleichsrechnungen mit wenigen Größen. Dass ihm einige hundert Beobachtungen genügen, liegt daran, dass er über seine Mechanik und die vorgegebene Form seiner Modelle vieles schon mitbringt, was ein Spielprogramm oder ein großes Robotermodell erst lernen muss.
Wo die Grenze zwischen Eingebautem und Gelerntem verläuft, ist in allen hier beschriebenen Systemen eine Abwägung. Die Hand-Auge-Kalibrierung ließe sich vorab messen, der Arm der Lerneinheit bestimmt sie trotzdem selbst, weil das einen Arbeitsschritt erspart. Die Zugfolge für den Zauberwürfel hätte man lernen lassen können, OpenAI hat sie trotzdem ausgerechnet, weil vorhandene Software das leicht erledigt. Gelernt wird, was vorab festzulegen aufwendiger oder störanfälliger wäre, als es zu lernen. Den Rest baut man ein. Nur die großen, aufgabenübergreifenden Robotermodelle verschieben diese Grenze weit in Richtung Lernen und bezahlen dafür mit Datenmengen, die in Tausenden von Stunden gemessen werden.
Woher die Angaben stammen
- International Federation of Robotics: World Robotics 2025, Pressemitteilung vom 25. September 2025.
- Zengxi Pan, Joseph Polden, Nathan Larkin, Stephen Van Duin, John Norrish: „Recent progress on programming methods for industrial robots“, Robotics and Computer-Integrated Manufacturing 28 (2), 2012, S. 87–94.
- Roger Y. Tsai, Reimar K. Lenz: „A new technique for fully autonomous and efficient 3D robotics hand/eye calibration“, IEEE Transactions on Robotics and Automation 5 (3), 1989, S. 345–358.
- Seth Hutchinson, Gregory D. Hager, Peter I. Corke: „A tutorial on visual servo control“, IEEE Transactions on Robotics and Automation 12 (5), 1996, S. 651–670.
- Koh Hosoda, Minoru Asada: „Versatile visual servoing without knowledge of true Jacobian“, IEEE/RSJ IROS, 1994, S. 186–193.
- Martin Jägersand, Olac Fuentes, Randal Nelson: „Experimental evaluation of uncalibrated visual servoing for precision manipulation“, IEEE ICRA, 1997, S. 2874–2880.
- Sergey Levine, Peter Pastor, Alex Krizhevsky, Deirdre Quillen: „Learning Hand-Eye Coordination for Robotic Grasping with Large-Scale Data Collection“, ISER 2016; erweitert als „Learning Hand-Eye Coordination for Robotic Grasping with Deep Learning and Large-Scale Data Collection“, mit Julian Ibarz, International Journal of Robotics Research 37 (4–5), 2018, S. 421–436, arXiv:1603.02199.
- Dmitry Kalashnikov und andere: „QT-Opt: Scalable Deep Reinforcement Learning for Vision-Based Robotic Manipulation“, 2018, arXiv:1806.10293.
- Emanuel Todorov, Tom Erez, Yuval Tassa: „MuJoCo: A physics engine for model-based control“, IEEE/RSJ IROS, 2012, S. 5026–5033.
- Josh Tobin, Rachel Fong, Alex Ray, Jonas Schneider, Wojciech Zaremba, Pieter Abbeel: „Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World“, IEEE/RSJ IROS 2017, arXiv:1703.06907.
- OpenAI (Ilge Akkaya und andere): „Solving Rubik’s Cube with a Robot Hand“, 2019, arXiv:1910.07113.
- Nikita Rudin, David Hoeller, Philipp Reist, Marco Hutter: „Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning“, CoRL 2021, arXiv:2109.11978.
- Amazon: „Introducing Vulcan: Amazon’s first robot with a sense of touch“, 2025.
- Anthony Brohan und andere: „RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control“, 2023, arXiv:2307.15818.
- Physical Intelligence (Kevin Black und andere): „π0: A Vision-Language-Action Flow Model for General Robot Control“, 2024, arXiv:2410.24164; RSS 2025.
- Robert Kwiatkowski, Hod Lipson: „Task-agnostic self-modeling machines“, Science Robotics 4 (26), 2019.
- Boyuan Chen, Robert Kwiatkowski, Carl Vondrick, Hod Lipson: „Fully body visual self-modeling of robot morphologies“, Science Robotics 7 (68), 2022.
- Eigene Messungen und Nachrechnungen an der Lerneinheit auf dieser Seite, September 2026.