← Zurück zu den Lerneinheiten

Was die Maschine sieht

Sechs Aufgaben, zwanzig Sekunden pro Zeichnung. Eine Maschine rät laut mit, während Sie noch malen, und legt sich fest, sobald Sie aufhören. Sie kennt 300 Begriffe und hat sie aus 3,4 Millionen fremder Kritzeleien gelernt. Am Ende stehen Ihre Zeichnungen neben denen anderer Leute. Die Maschine rechnet dabei vollständig in Ihrem Browser.

Papierszene: Ein Mann zeichnet mit einem dicken Stift eine Schnecke auf ein Blatt. Hinter ihm läuft eine Uhr ab. Rechts steht eine kleine Maschine aus Pappe und wirft Kärtchen mit ihren Vermutungen aus: Hut, Pfanne, Schnecke.Spiel starten ↗

Das Spiel öffnet sich in einem eigenen Tab und braucht einen Bildschirm ab Laptopgröße; auf dem Handy lässt es sich schlecht zeichnen, der Artikel darunter liest sich überall. Die Maschine spricht, der Ton lässt sich abschalten. Nichts von dem, was Sie zeichnen, verlässt Ihren Rechner.

Gemessen habe ich das in Chrome; Edge und Safari bringen dieselben Bausteine mit. Firefox nimmt die Stimmen des Betriebssystems, und wo keine deutsche installiert ist, bleibt die Maschine stumm und zeigt ihre Vermutung nur als Balken und Ton. Was Ihr Browser mitbringt, zeigt eine kurze Prüfung.

Wie die Maschine Muster erkennt

Sie haben gerade sechs Dinge gezeichnet, und eine Stimme hat mitgeraten, während Sie noch malten. Wahrscheinlich lag die Maschine ein paarmal daneben, und zwar anders, als Sie erwartet hätten. Hier steht, warum.

Das Spiel oben ist ein Nachbau von Googles „Quick, Draw!“. Zwei Dinge macht es anders: Es zeigt, wie die Vermutung mit jedem Strich kippt. Und es rechnet vollständig in Ihrem Browser. Nichts von dem, was Sie zeichnen, verlässt Ihren Rechner.

Sie sieht Formen, keine Dinge

Was in der Maschine vorgeht, während sie rät, lässt sich von außen nicht ablesen. Was man sehen kann, sind ihre Fehler, und die sind aufschlussreich.

Am häufigsten verwechselt sie Achteck mit Sechseck, Becher mit Tasse, Jacke mit Pullover und Fahrrad mit Motorrad. Das sind Paare, die sich wirklich ähneln, da würde auch ein Mensch zögern. Die zweite Sorte Fehler ist die interessante: Baum und Brokkoli. Kompass und Uhr. Mond und Keks. Diese Dinge haben nichts miteinander zu tun. Sie sehen nur gleich aus, wenn man sie mit wenigen Strichen zeichnet.

Daran erkennt man, worauf die Maschine achtet. Nicht darauf, was ein Ding ist, sondern darauf, welche Form auf dem Papier entsteht. Ein Brokkoli ist für sie ein Baum mit kürzerem Stiel. Den Mond erkennt sie nur in der Hälfte der Fälle. Sonst hält sie ihn für einen Kreis, einen Keks oder eine Banane. Wer den Mond als Sichel zeichnet, hat bessere Chancen als jemand, der ihn rund malt, denn rund sieht er aus wie vieles andere auch.
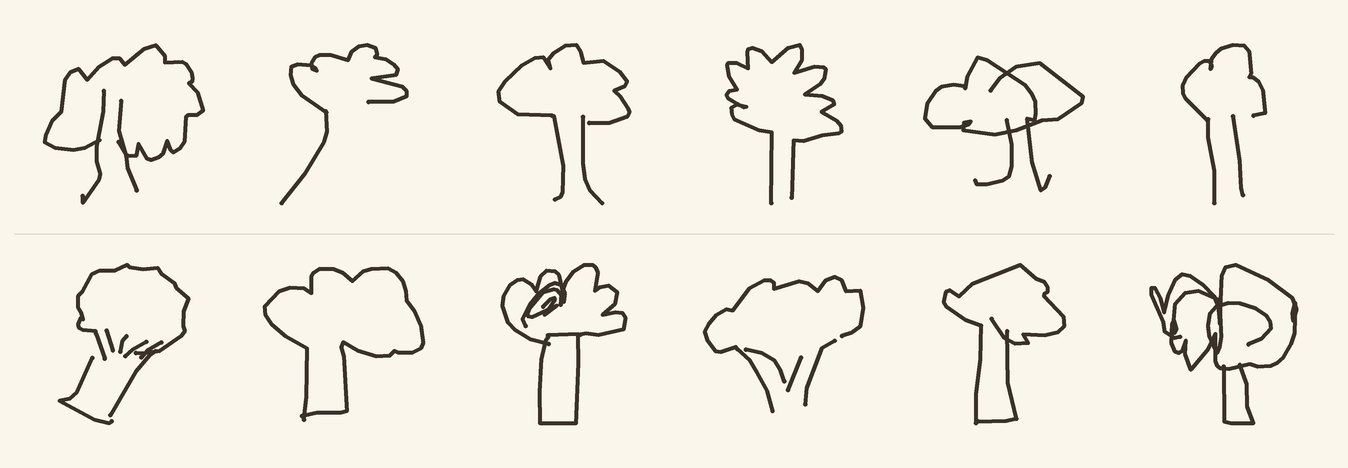
Zwölf Strichzeichnungen in zwei Reihen. Oben sechs Bäume, unten sechs Brokkoli, die sich kaum unterscheiden.
Oben sechs Bäume, unten sechs Brokkoli, so wie Spieler von „Quick, Draw!“ sie gezeichnet haben. Aus solchen Kritzeleien hat die Maschine gelernt. Zeichnungen: Quick, Draw!-Datensatz von Google, CC BY 4.0

Die Prozentzahlen neben den Balken sagen dabei nicht, wie sicher die Maschine sich ist. Dahinter steckt eine Umrechnung der Werte, die am Ende des Netzes stehen. Solche Netze geben sich gern zu sicher. Auch bei neunzig Prozent kann sie falsch liegen.

Was beim Raten wirklich passiert

Die Maschine vergleicht Ihre Zeichnung nicht mit einem gespeicherten Bild von einem Hund. So etwas gibt es in ihr nicht. Sie rechnet die Zeichnung durch ein Netz aus 945.164 Zahlen. Am Ende steht für jeden der 300 Begriffe ein Wert. Der höchste gewinnt.

Diese Zahlen sind alles, was beim Lernen entstanden ist. Sie wurden so lange nachjustiert, bis die Antworten für Millionen fremder Zeichnungen meistens stimmten. Was sie einzeln bedeuten, weiß niemand, auch die Leute nicht, die solche Netze bauen. Man kann sie auslesen, aber nicht lesen.

Eine Milliarde fremder Kritzeleien
Google hat „Quick, Draw!“ 2016 nicht als Spielerei gebaut, sondern um an Daten zu kommen. Über eine Milliarde Zeichnungen aus 236 Ländern sind zusammengekommen, und fünfzig Millionen davon hat Google unter einer freien Lizenz veröffentlicht. Der Aufwand hinter diesem Spiel ist also längst bezahlt, und zwar von über fünfzehn Millionen Menschen. Wer heute so etwas bauen will, muss nichts mehr sammeln.

Von Googles 345 Begriffen sind hier 300 übrig. Sechs sind ausgeschieden, weil sie niemand zeichnen kann, darunter „Tierwanderung“ und „Yoga“. Neununddreißig weitere sind gestrichen, weil die Maschine sie zu selten erkannt hat. Eine Reihe von Alltagsbegriffen habe ich gegen die Zahlen behalten. Hund, Bär, Vogel und Frosch stehen weit unten in der Erkennungsliste, aber ein Zeichenspiel ohne Hund ist keins.

Vierzig Minuten auf einem Laptop

Das Lernen selbst ist unspektakulär: 3,4 Millionen Zeichnungen, fünf Durchgänge, vierzig Minuten auf einem gewöhnlichen Laptop. Danach steht fest, was das Programm kann. Es lernt nicht weiter.

Übrig bleibt dabei erstaunlich wenig. Die Maschine hat aus 2,7 Gigabyte Bildmaterial gelernt. Ausgeliefert wird eine Datei von 1,2 Megabyte. Auf einen Begriff kommen damit rund vier Kilobyte. Was die Maschine über Hunde weiß, passt in eine sehr kleine Datei.

Was sie gut kann und was nicht

Die folgenden Zahlen stammen aus einer Messung an 44.229 Zeichnungen, die beim Lernen zurückgehalten wurden. Das Netz hatte sie nie zuvor gesehen.

Am zuverlässigsten erkennt sie Leiter, Briefumschlag, Kopfhörer und Dreieck, alle über 91 Prozent. Diese Dinge haben eines gemeinsam: Es gibt genau eine Art, sie zu kritzeln. Ein Briefumschlag ist ein Rechteck mit zwei Diagonalen, immer.

Ganz unten stehen Bär und Hund mit je 33 Prozent, dann Frosch, Maus und Vogel. Auch sie haben etwas gemeinsam, und es liegt nicht an der Maschine: Jeder Mensch zeichnet einen Hund anders, und die wenigsten zeichnen ihn gut. Wo die Vorlagen uneinheitlich sind, kann kein Muster entstehen.
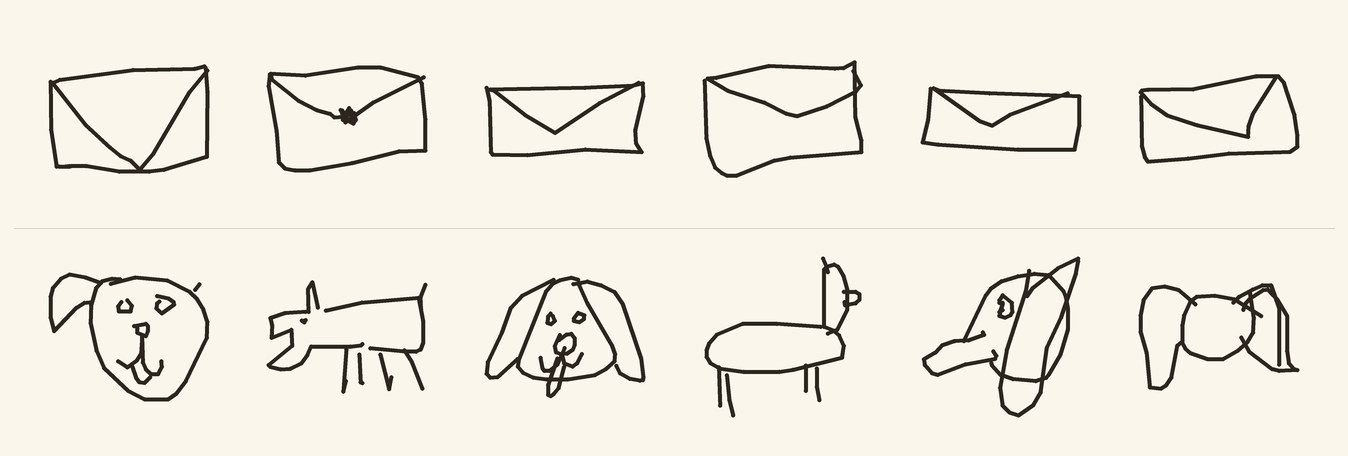
Zwölf Strichzeichnungen in zwei Reihen. Oben sechs Briefumschläge, die sich stark ähneln, unten sechs Hunde, von denen keiner dem anderen gleicht.
Oben sechs Briefumschläge, unten sechs Hunde. Den Umschlag zeichnen alle gleich, den Hund jeder anders. Zeichnungen: Quick, Draw!-Datensatz von Google, CC BY 4.0

Über alle 300 Begriffe erkennt sie 73 Prozent der Zeichnungen richtig. Zählt man mit, wenn der gesuchte Begriff unter den ersten drei Vermutungen steht, sind es 87 Prozent.

Warum das Rechnen bei Ihnen stattfindet

Googles Spiel schickt beim Zeichnen etwa jede Sekunde eine Anfrage an einen Server, der die Erkennung übernimmt. In einer mitgeschnittenen Runde waren das 153 Anfragen bei 252 Strichen.

Hier ist das anders, aus einem praktischen Grund: Diese Seite soll keine laufenden Kosten verursachen, egal wie viele Leute sie besuchen. Das Modell wird einmal geladen und rechnet danach im Browser. Eine Vermutung dauert dort zwischen 50 und 90 Tausendstelsekunden. Möglich wären zehn Vermutungen in der Sekunde und mehr. Das Spiel rechnet dreimal pro Sekunde, sonst flackert die Anzeige.

Jede Zahl des Modells ist von einer Kommazahl auf ein einzelnes Byte zusammengestaucht, damit die Datei klein genug bleibt. Statt 3,6 Megabyte sind es 1,2, und die Trefferquote sinkt dabei um 0,01 Prozentpunkte.

Eine Stelle, an der alles kippt
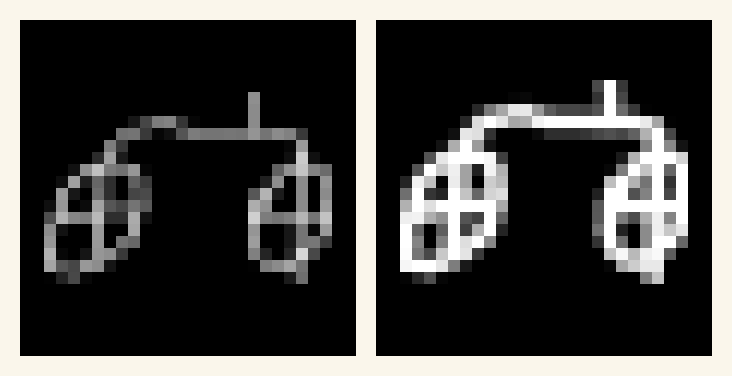
Zweimal dieselbe Fahrradzeichnung als grobes Bild aus weißen Bildpunkten auf Schwarz. Links sind die Linien dünn und blass, rechts dick und hell.
So kommt eine Fahrradzeichnung bei der Maschine an, 28 mal 28 Bildpunkte groß. Links mit dem zu dünnen Strich der ersten Fassung, rechts mit dem Strich, mit dem sie gelernt hat. Zeichnungen: Quick, Draw!-Datensatz von Google, CC BY 4.0

Beim Bauen ging etwas schief, das mehr über solche Systeme sagt als jede Erfolgsmeldung. Das Modell hat mit Bildern gelernt, die Google aus den Strichdaten erzeugt hat. Wenn der Browser die Striche des Besuchers auch nur geringfügig anders in ein Bild umrechnet, bricht die Erkennung zusammen. In der ersten Fassung war der Strich sechs statt sechzehn Punkte breit, und die Trefferquote fiel von 97 auf 44 Prozent.

Der Fehler bleibt unsichtbar. Es gibt keine Fehlermeldung, keinen Absturz, keinen Hinweis. Es sieht nur so aus, als sei die Maschine dumm. Gefunden hat ihn eine eingebaute Gegenprobe, die bekannte Bilder durchrechnet und prüft, ob das erwartete Ergebnis herauskommt. Ohne sie stünde hier ein Spiel, das schlecht funktioniert, und niemand wüsste, warum.

Das ist die unangenehmste Eigenschaft dieser Systeme: Sie merken selbst nicht, wenn sie falsch liegen.

Dasselbe Verfahren, größer

Das Spiel ist ein Spielzeug, das Verfahren dahinter nicht. Nach demselben Prinzip liest die Post handgeschriebene Adressen. Kameras erkennen so Nummernschilder. Der Unterschied liegt in der Menge der Daten und in der Größe des Netzes.

Die Eigenart bleibt dabei dieselbe. Ein solches System erkennt keine Gegenstände, es erkennt Muster in Bildpunkten. Es kann auch nicht sagen, dass es etwas nicht kennt. Es nennt immer den nächstliegenden Begriff aus seiner Liste. Zeichnen Sie eine Zitrone, die unter den 300 Begriffen nicht vorkommt, bekommen Sie trotzdem eine Antwort, und zwar eine selbstbewusste.

Woher die Angaben stammen

  • Google Creative Lab: „Quick, Draw!“, 2016, quickdraw.withgoogle.com. Der daraus veröffentlichte Datensatz mit fünfzig Millionen Zeichnungen in 345 Kategorien steht unter der Lizenz Creative Commons Attribution 4.0.
  • Google Open Source Blog: „Introducing a Web Component and Data API for Quick, Draw!“, 2018, mit den Angaben zu Umfang und Herkunft der Sammlung.
  • Sämtliche Prozentzahlen, Verwechslungen und Zeitangaben stammen aus eigenen Messungen am Modell dieser Seite, September 2026. Die Trefferquoten sind an 44.229 Zeichnungen gemessen, die beim Training zurückgehalten wurden.

Erkennen ist nicht das Einzige, was Maschinen lernen.

Wie ein Bildprogramm aus reinem Rauschen ein Bild macht, zeigt „Wie KI-Bilder entstehen“. Wie ein Programm Vier gewinnt lernt, indem es gegen sich selbst spielt, zeigt „Der einzige gewinnende Zug“. Und wie eine lernende Maschine von 1960 aussah, zeigt der Nachbau des Perceptron Mark I.

Über mich

Ich bin Matthias Stiefel und erkläre KI.

Ich betreibe diese Website privat, weil ich wissen will, was Künstliche Intelligenz heute kann und wie sie das macht.

Die meisten Beiträge hier erklären KI für Menschen ohne Fachwissen. Sie zeigen etwa, was in einem Sprachmodell wie ChatGPT passiert, warum es manchmal Antworten erfindet und wem die Texte und Bilder gehören, aus denen eine KI lernt. Dazu gibt es kurze Filme und Lerneinheiten. In den Lerneinheiten kann man selbst etwas ausprobieren, zum Beispiel das Brettspiel Go gegen eine Maschine spielen oder mit ELIZA chatten, einem Chatprogramm aus den 1960er-Jahren.

Mich interessiert vor allem, ob eine KI-Anwendung im Alltag funktioniert und ob sie jemandem Arbeit abnimmt. Auf der Startseite stehen unter „Aus der Werkstatt“ Programme, die ich selbst gebaut habe, etwa ein Diktier-Assistent.

Der Name der Website, caligatus, ist lateinisch und spielt auf meinen Nachnamen Stiefel an. Die caliga war der Stiefel der römischen Legionäre, und caligatus hieß der einfache Soldat, der sie trug.

Impressum

Angaben gemäß § 5 DDG

Matthias Stiefel
Ahornstraße 15
82223 Eichenau

Kontakt
E-Mail: caligatus@gmx.de

Verantwortlich für den Inhalt nach § 18 Abs. 2 MStV
Matthias Stiefel, Anschrift wie oben

Datenschutzerklärung

Stand: Oktober 2026

Verantwortlicher

Matthias Stiefel
Ahornstraße 15
82223 Eichenau
E-Mail: caligatus@gmx.de

Allgemeines

Sie haben jederzeit das Recht auf Auskunft, Berichtigung, Löschung und Einschränkung der Verarbeitung Ihrer Daten sowie auf Datenübertragbarkeit. Zudem können Sie sich bei einer Datenschutz-Aufsichtsbehörde beschweren, zuständig ist das Bayerische Landesamt für Datenschutzaufsicht (BayLDA).

Hosting / Server-Log-Dateien

Diese Website wird auf einem Server bei Hostinger betrieben. Beim Aufruf der Seite verarbeitet der Server automatisch technische Verbindungsdaten (u. a. IP-Adresse, Datum/Uhrzeit, aufgerufene Seite, Browsertyp) in Server-Logs. Rechtsgrundlage: Art. 6 Abs. 1 lit. f DSGVO (berechtigtes Interesse an einem funktionierenden, sicheren Betrieb). Speicherdauer: wenige Tage bis Wochen.

Google Fonts

Diese Website lädt Schriftarten direkt von Servern von Google. Dabei wird Ihre IP-Adresse an Google übertragen. Rechtsgrundlage: Art. 6 Abs. 1 lit. f DSGVO. Mehr dazu in der Google-Datenschutzerklärung.

Kontaktformular

Bei Nutzung des Kontaktformulars verarbeite ich Name, E-Mail-Adresse und Nachricht, um Ihre Anfrage zu beantworten. Die Daten werden an meinen selbst betriebenen n8n-Server übertragen, der Bestätigungsmail, Benachrichtigung per E-Mail (Gmail) und Telegram-Push übernimmt. Rechtsgrundlage: Art. 6 Abs. 1 lit. b bzw. f DSGVO. Empfänger: mein n8n-Server, Google (Gmail), Telegram FZ-LLC. Ihre Nachricht verbleibt in meinem Postfach, bis ich sie lösche.

Gästebuch

Im Gästebuch können Sie einen öffentlich sichtbaren Eintrag hinterlassen (Name, Nachricht). Jeder Eintrag wird von mir persönlich geprüft und freigegeben oder abgelehnt. Zusätzlich wird Ihre IP-Adresse zur Missbrauchsprävention verarbeitet (max. 1 Einreichung/Stunde). Freigegebene Einträge bleiben öffentlich sichtbar, bis ich sie entferne; nicht freigegebene Einträge werden nach 30 Tagen automatisch gelöscht. Rechtsgrundlage: Art. 6 Abs. 1 lit. a DSGVO (Ihre Einwilligung durch Absenden). Empfänger: mein n8n-Server, Telegram FZ-LLC und Google (Gmail) für die Freigabe-Benachrichtigung an mich.

Zugangsanfrage für die Konzeptstudien

Wer Zugang zum geschützten Bereich „Konzeptstudien“ anfragt, übermittelt Name, E-Mail-Adresse und auf Wunsch Firma und Anlass. Dazu wird die IP-Adresse zur Missbrauchsprävention verarbeitet (max. 1 Anfrage/Stunde). Ich prüfe jede Anfrage persönlich. Bei einer Freigabe erhalten Sie Nutzername und Passwort per E-Mail; das Passwort wird auf dem Server nur verschlüsselt gespeichert. Abgelehnte und unbearbeitete Anfragen werden nach 30 Tagen gelöscht, bei freigegebenen Zugängen bleiben Name, E-Mail-Adresse und Nutzername bis zum Entzug des Zugangs gespeichert. Rechtsgrundlage: Art. 6 Abs. 1 lit. b und f DSGVO. Empfänger: mein n8n-Server, Telegram FZ-LLC und Google (Gmail). Einzelheiten stehen im Datenschutzhinweis auf der Anfrageseite.

Kamera und Sprachausgabe in den Lerneinheiten

Die Lerneinheit „Bilderkennung zum Selbermachen“ nutzt die Kamera Ihres Geräts, aber erst, nachdem Sie das im Browser erlaubt haben. Die Kamerabilder werden ausschließlich in Ihrem Browser verarbeitet. Kein Bild und kein daraus berechneter Wert wird an meinen Server oder an Dritte übertragen, nichts wird gespeichert, und beim Schließen der Seite ist alles gelöscht. Ich selbst erhalte also keine Kameradaten. Die Freigabe können Sie jederzeit in den Einstellungen Ihres Browsers zurücknehmen.

Einige Lerneinheiten sprechen mit der Sprachausgabe Ihres Browsers. Sie bevorzugen dabei Stimmen, die auf Ihrem Gerät selbst laufen. Gibt es keine solche Stimme, kann Ihr Browser den gesprochenen Text an einen Server seines Herstellers schicken, in Chrome etwa bei den Stimmen mit „Google“ im Namen. Darauf habe ich keinen Einfluss. Wer das vermeiden möchte, schaltet den Ton in der Einheit ab.

SSL/TLS-Verschlüsselung

Diese Website nutzt aus Sicherheitsgründen eine SSL/TLS-Verschlüsselung (erkennbar an „https://" und dem Schloss-Symbol im Browser).