Von der Nervenzelle zum Sprachmodell
Achtzig Jahre künstliche Intelligenz, der Reihe nach erzählt.
Im Juli 1958 berichtete die New York Times über einen Rechner, den die amerikanische Marine vorgeführt hatte. Die Marine erwarte, schrieb die Zeitung, dass diese Maschine eines Tages laufen, sprechen, sehen und schreiben werde, sich selbst nachbauen könne und sich ihrer Existenz bewusst sei. Die Maschine hieß Perceptron. Entwickelt hatte sie der Psychologe Frank Rosenblatt mit Geld der Marine. Die sechs Erwartungen stammen nicht von ihm. Ein Reporter hatte aufgeschrieben, was die Marine sich erhoffte.
Dieser Artikel erzählt, wie es zu der Maschine kam und was aus ihr wurde. Er folgt dem Dokumentarfilm oben auf dieser Seite und erzählt ausführlicher, was dort nur kurz vorkommt. Zu mehreren Stationen gibt es auf dieser Website eigene Seiten zum Ausprobieren, auf die der Text jeweils verweist.
Eine Nervenzelle als Schalter
Angefangen hat es 1943 in Chicago, mit einem Aufsatz über Nervenzellen. Geschrieben haben ihn zwei sehr ungleiche Männer. Warren McCulloch war Hirnforscher, Mitte vierzig und Professor. Walter Pitts war zwanzig. Er war mit fünfzehn von zu Hause fortgelaufen und saß seit Jahren in Vorlesungen der Universität Chicago, ohne eingeschrieben zu sein. Einen Abschluss hat er nie gemacht.
Die beiden beschrieben, was eine Nervenzelle tut. Sie schickt ein Signal los, sobald genug Signale von anderen Zellen bei ihr ankommen, oder sie bleibt still. Etwas dazwischen gibt es nicht. Eine Nervenzelle ist ein Schalter. Daraus zogen sie einen Schluss. Wenn das Gehirn aus Schaltern besteht, lässt es sich nachbauen. Verbindet man genug solcher Schalter zu einem Netz, kann dieses Netz alles ausrechnen, was sich überhaupt ausrechnen lässt. Ein solches Netz heißt heute künstliches neuronales Netz.
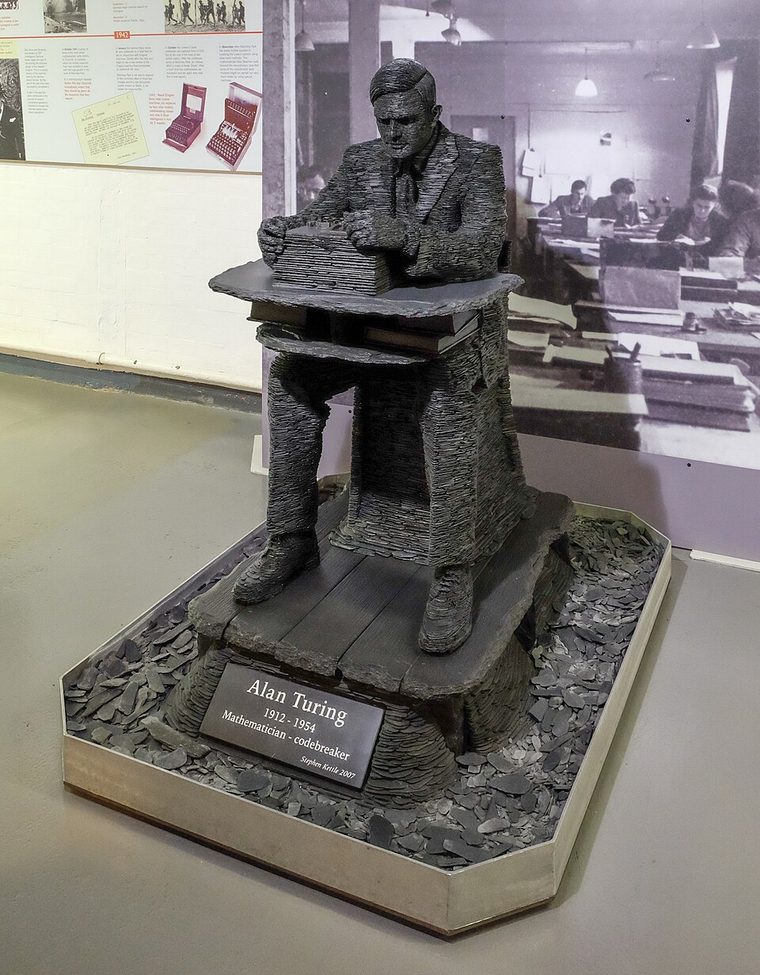

Wie ein Netz etwas lernen soll, stand in dem Aufsatz nicht. Der britische Mathematiker Alan Turing machte 1948 einen Vorschlag dazu. In einem Bericht für sein Forschungslabor beschrieb er eine Maschine, deren Schalter zunächst zufällig verbunden sind und die erst durch Übung Ordnung bekommt, durch Belohnung und Bestrafung. Der Direktor des Labors hielt den Bericht für einen Schulaufsatz und legte ihn weg. Gedruckt wurde er erst nach Turings Tod.
1949 beschrieb der kanadische Psychologe Donald Hebb, wie das Lernen im Gehirn vor sich gehen könnte. Schicken zwei Nervenzellen immer wieder gemeinsam ein Signal, dann wird die Verbindung zwischen ihnen stärker. Lernen wäre demnach eine Frage der Verbindungen und ihrer Stärke. Dass das Gelernte in der Stärke der Verbindungen steckt, gilt bis heute für jedes künstliche neuronale Netz.
1950 stellte Turing in einer Fachzeitschrift die Frage, die seither jeder stellt. Können Maschinen denken? Er verwarf sie im selben Aufsatz. Die Frage sei sinnlos, schrieb er, über sie lohne sich kein Streit. Stattdessen beschrieb er ein Spiel. Ein Fragesteller sitzt in einem Raum und darf zwei Personen in einem anderen Raum schriftlich befragen, einen Mann und eine Frau. Er soll herausfinden, wer von beiden die Frau ist, und der Mann versucht, ihn zu täuschen. Dann kam Turings eigentliche Frage. Was geschieht, wenn an der Stelle des Mannes eine Maschine sitzt? Merkt der Fragesteller dann, dass er es mit einer Maschine zu tun hat? Aus diesem Spiel wurde später der Turing-Test.
Turing wagte zwei Vorhersagen für die Zeit um das Jahr 2000. Eine Maschine werde das Spiel dann so gut spielen, dass ein durchschnittlicher Fragesteller sie nach fünf Minuten in mindestens drei von zehn Fällen nicht erkennt. Und man werde ganz selbstverständlich von denkenden Maschinen sprechen, ohne dass jemand widerspricht. Die zweite Vorhersage betraf also uns und unseren Sprachgebrauch. Von denkenden Maschinen spricht heute tatsächlich fast jeder.
Ein Sommer in Dartmouth

Einen Namen hatte das alles noch nicht. Im Sommer 1955 schrieb John McCarthy, ein junger Mathematiker am Dartmouth College im Bundesstaat New Hampshire, mit drei Kollegen einen Antrag auf Fördergeld bei der Rockefeller-Stiftung. Einer der drei war Marvin Minsky von der Harvard-Universität, von dem noch die Rede sein wird. Sie planten ein Treffen und brauchten einen Titel dafür. McCarthy schrieb hinein: künstliche Intelligenz. Das ist die erste bekannte Verwendung des Begriffs.
McCarthy hat später erklärt, warum er ein neues Wort wollte. Für das Nachdenken über Maschinen und Gehirne gab es schon eines, die Kybernetik, und mit ihr einen berühmten Wortführer, den Mathematiker Norbert Wiener. McCarthy wollte Wiener weder als Autorität anerkennen noch sich mit ihm streiten müssen. Ein eigener Name ersparte ihm beides.
Der Antrag ging von einer Vermutung aus. Jede Seite des Lernens und der Intelligenz lasse sich so genau beschreiben, dass eine Maschine sie nachahmen kann. Zehn Leute sollten zwei Monate lang daran arbeiten, und dafür baten die vier um 13.500 Dollar. Die Stiftung bewilligte gut die Hälfte. Das Gebiet sei noch schwer zu fassen, schrieb der zuständige Mitarbeiter, es rechtfertige nur einen bescheidenen Einsatz.
Das Treffen fand im Sommer 1956 statt. Zehn Leute saßen dabei nie an einem Tisch. Die meisten kamen für einige Tage und fuhren wieder, durchgehend da waren nur drei. Die Stiftung habe längst nicht genug Geld gegeben, sagte McCarthy später, und die Leute hätten andere Verpflichtungen gehabt.
Einer der drei, die blieben, war der junge Physiker Ray Solomonoff. Er schrieb am Ende des Sommers in sein Notizbuch, das Treffen sei wenig ergiebig gewesen. Immerhin habe er interessante Leute kennengelernt und wisse jetzt, wie dürftig auf diesem Gebiet gedacht werde.
Dieses Treffen gilt seither als Geburtsstunde der künstlichen Intelligenz.
Die Maschine, die an Beispielen lernt
Zwei Jahre später, 1958, kam die Zeitungsmeldung vom Anfang. Frank Rosenblatt forschte in Buffalo im Bundesstaat New York und hatte Hebbs Gedanken ernst genommen. Sein Perceptron war ein Netz aus künstlichen Schaltern, dem niemand Regeln vorgab. Man zeigte ihm Beispiele und sagte ihm jeweils, ob seine Antwort stimmte. Nach jedem Fehler verstellte es die Stärke seiner Verbindungen ein wenig.
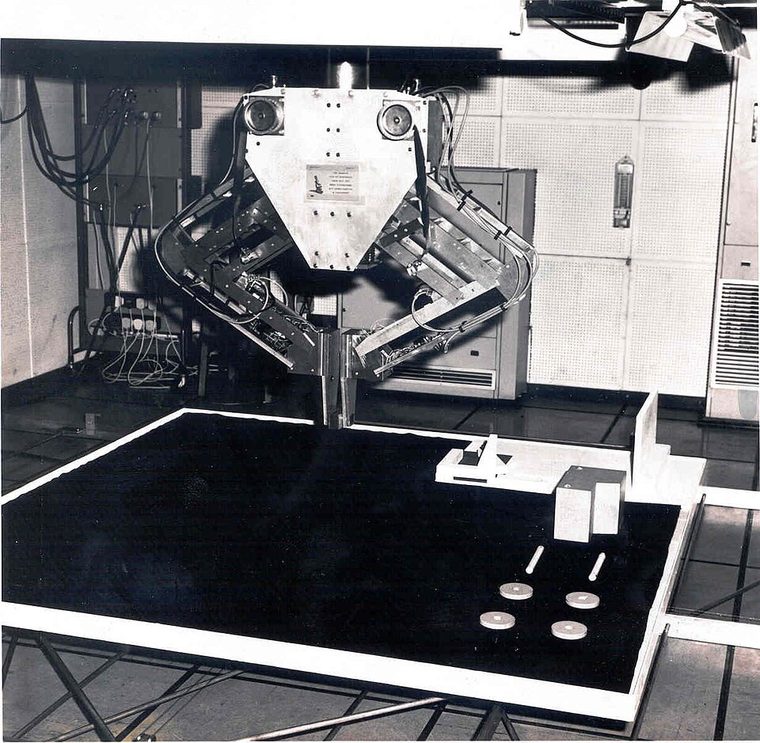
Zuerst gab es das Perceptron nur als Nachbildung auf einem Großrechner. Man legte ihm Lochkarten vor, die links oder rechts markiert waren, und es lernte, die beiden Sorten auseinanderzuhalten. 1960 folgte ein eigenes Gerät mit 400 Fotozellen als Auge, das Mark I Perceptron. Es lernte, Buchstaben auseinanderzuhalten, etwa das X vom E. Wie es gebaut war, steht auf der Seite „Das Perceptron Mark I“. Dort lässt sich ein Nachbau auch selbst anlernen.

Beim Perceptron lagen alle Schalter nebeneinander in einer einzigen Reihe. Fachleute nennen eine solche Reihe eine Schicht. 1969 veröffentlichten zwei Mathematiker vom Massachusetts Institute of Technology, kurz MIT, ein Buch über diese Bauart. Der eine war Marvin Minsky, einer der vier Antragsteller von 1955, der andere Seymour Papert. Sie bewiesen, was eine einzelne Schicht nicht schafft. Zeichnet man eine verschlungene Linie auf ein Blatt, sieht jedes Kind, ob sie durchgehend ist oder ob es zwei getrennte Linien sind. Ein Perceptron dieser Bauart sieht es nicht, gleichgültig, wie lange man es üben lässt. Jeder seiner Schalter ist nur mit einem Teil der Fotozellen verbunden und sieht deshalb nur einen Ausschnitt des Bildes, und ob zwei Ausschnitte zur selben Linie gehören, kann keiner von ihnen feststellen.
Der naheliegende Ausweg waren mehrere Schichten hintereinander, bei denen die zweite zusammensetzt, was die erste in den Ausschnitten gefunden hat. Minsky und Papert hielten auch das für aussichtslos. Bewiesen haben sie es nicht. Es war ihre Einschätzung, und sie schrieben selbst dazu, jemand solle sie nachprüfen. Die Fachwelt nahm aus dem Buch vor allem mit, dass es nicht geht.
Rosenblatt blieb wenig Zeit zu widersprechen. Er ertrank am 11. Juli 1971, seinem 43. Geburtstag, bei einem Bootsunglück. Die zweite Auflage des Buchs trägt eine Widmung an ihn. Aus eben den mehrschichtigen Netzen, die 1969 als aussichtslos galten, besteht heute fast jedes System, das künstliche Intelligenz genannt wird.
Das Programm, das zurückfragt
Am MIT entstand in denselben Jahren ein Programm ganz anderer Art. 1966 stellte der Informatiker Joseph Weizenbaum ELIZA vor, ein Programm, das Gespräche führte. Weizenbaum war 1923 in Berlin geboren und 1936 mit seiner Familie vor den Nationalsozialisten in die USA geflohen.

ELIZA spielte einen Psychotherapeuten. Das Programm suchte in jedem Satz nach Schlüsselwörtern und stellte den Satz um. Aus „Ich bin traurig“ wurde „Warum sind Sie traurig?“. Die Rolle hatte Weizenbaum aus einem einzigen Grund gewählt. Ein Therapeut darf zurückfragen, ohne etwas über die Welt zu wissen. Das Programm war für seine Zeit aufwendig gebaut. Nur verstand es nichts von dem, was es schrieb.
Was dann geschah, hat Weizenbaum später selbst erzählt. Seine Sekretärin hatte ihm monatelang beim Programmieren zugesehen und wusste genau, was ELIZA war. Sie begann ein Gespräch mit dem Programm und bat dann ihren Chef, den Raum zu verlassen. Sie wollte mit ELIZA allein sein. Ein paar Minuten mit einem vergleichsweise einfachen Programm reichten, schrieb er, und ganz normale Menschen sähen darin etwas, was nicht da ist.
Was in den siebziger und achtziger Jahren auf Heimcomputern als ELIZA lief, waren Nachbauten. Wer sie schrieb, kannte das Original nicht, denn gedruckt waren nur eine Beschreibung und die Gesprächsregeln, nicht das Programm selbst. 2021 durchsuchte der Programmierer Jeff Shrager zusammen mit einem Archivar des MIT den Nachlass Weizenbaums und fand einen Ausdruck des Originals, rund 2.600 Zeilen lang. Am 21. Dezember 2024 lief es zum ersten Mal seit fast sechzig Jahren wieder. Die ganze Geschichte steht auf der Seite „ELIZA“. Dort kann man mit dem Programm auch selbst sprechen.
Das Geld bleibt aus
Zurück in die sechziger Jahre. Die Geldgeber hatten zehn Jahre lang Versprechen gehört und wollten Ergebnisse sehen. Als Erstes traf es die maschinelle Übersetzung. Die amerikanische Regierung hatte jahrelang Programme gefördert, die russische Fachtexte ins Englische übertragen sollten. 1966 kam ein Gutachtergremium unter dem Ingenieur John Pierce zu dem Schluss, brauchbare maschinelle Übersetzung sei nicht in Sicht. Der größte Teil der Förderung endete.

In Großbritannien kam der Einschnitt 1973. Der Forschungsrat, der die staatlichen Mittel verteilte, wollte einem Labor in Edinburgh das Geld streichen und bestellte ein Gutachten beim Mathematiker James Lighthill. Lighthill urteilte dann über die gesamte KI-Forschung. In keinem ihrer Teile, schrieb er, sei eingetreten, was versprochen worden war. Im Mai 1973 verteidigte er seinen Bericht in London öffentlich gegen drei Forscher, unter ihnen John McCarthy, und die BBC sendete die Debatte im Fernsehen. Das Labor in Edinburgh verlor sein Geld.
Für die Jahre danach hat sich später der Ausdruck KI-Winter eingebürgert. Gemeint ist, dass das Geld ausblieb. Geforscht wurde weiter. Die KI-Fachgruppe im amerikanischen Informatikverband hatte 1973 gut 1.200 Mitglieder, fünf Jahre später waren es rund 3.500, fast dreimal so viele. Getroffen hat es vor allem einige große Labore.
Wissen von Hand
Neben den lernenden Netzen gab es von Anfang an einen zweiten Weg. Wenn Maschinen nicht selbst lernen können, muss man ihnen jede Regel einzeln beibringen. In den siebziger und achtziger Jahren bestimmte dieser Weg das Fach. Begonnen hatte er 1965 an der Universität Stanford. Der Informatiker Edward Feigenbaum und der Genetiker Joshua Lederberg bauten dort ein Programm namens DENDRAL, das Chemikern half, aus Messwerten den Aufbau eines Moleküls zu bestimmen. Sein Wissen bestand aus Regeln, die Fachleute ihm diktiert hatten. Erfolg hatten die beiden nach eigener Darstellung erst, als sie aufhörten, ein Programm für alles zu wollen, und eines für eine einzige Aufgabe bauten.
Solche Programme hießen bald Expertensysteme, weil sie das Wissen von Fachleuten als Regeln der Form „wenn dies, dann das“ enthielten. Das bekannteste entstand ab 1972 ebenfalls in Stanford und hieß MYCIN. Es schlug Ärzten vor, welches Antibiotikum bei einer schweren Infektion zu geben sei. In einem Vergleich bewerteten Gutachter die Empfehlungen, ohne zu wissen, von wem sie stammten. Die von MYCIN hielten sie in 65 Prozent der Fälle für vertretbar. Keiner der fünf Medizinprofessoren, die zum Vergleich antraten, kam auf einen höheren Wert. In einer Klinik eingesetzt wurde MYCIN trotzdem nie. Es ließ sich nicht an die Patientenakten anschließen, und die Ärzte hätten jeden Messwert von Hand eintippen müssen.
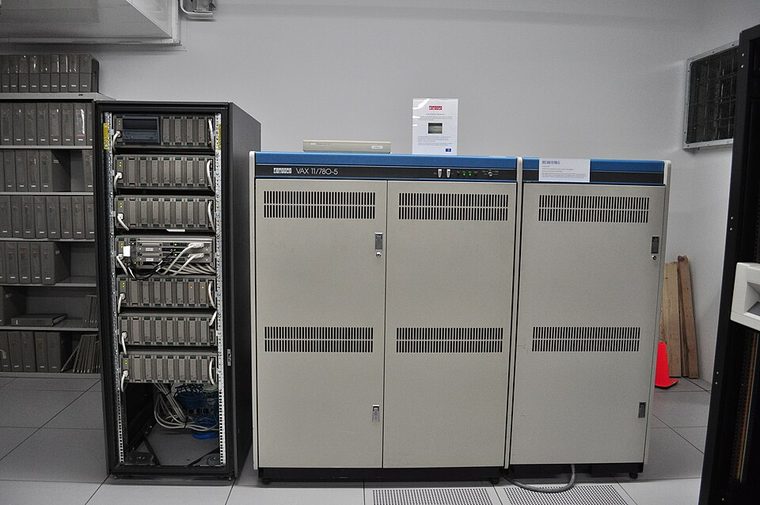

Eines der ersten Programme, die einem Unternehmen Geld sparten, hieß XCON. Es lief ab 1980 bei Digital Equipment, damals einem der größten Computerhersteller der Welt. Wer dort einen Rechner bestellte, bekam an die hundert Einzelteile, und jemand musste prüfen, ob die Bestellung überhaupt zusammenpasste. Das erledigte nun XCON. Bis 1986 hatte es 80.000 Aufträge bearbeitet. Sein Wissen bestand aus rund 2.500 Regeln, von Menschen einzeln aufgeschrieben.
Daraus wurde ein Geschäft. Firmen verkauften Expertensysteme, andere bauten eigens Rechner, auf denen sie besonders schnell liefen. Japan startete 1982 ein staatliches Zehnjahresprogramm für Computer, die aus Regeln selbst Schlüsse ziehen sollten. Das erklärte Ziel erreichte es nicht.
1984 wollte der Informatiker Douglas Lenat in Texas das Regelschreiben zu Ende führen. Sein Team begann, alles aufzuschreiben, was Menschen über die Welt wissen. Dass Wasser nass macht. Dass niemand an zwei Orten zugleich sein kann. Dass ein Mensch, der gestorben ist, tot bleibt. Nichts davon steht in Büchern, weil es zu selbstverständlich ist, und genau deshalb fehlt es jeder Maschine. Jeder dieser Sätze musste so genau formuliert werden, dass ein Programm damit rechnen konnte, und jeder zog neue nach sich. Wer festhält, dass Wasser nass macht, muss auch festhalten, was nass bedeutet, dass Wasser in Gläser gefüllt wird und was geschieht, wenn ein Glas umfällt.
Das Projekt hieß Cyc. Geplant war die Arbeit von 35 Leuten über zehn Jahre. Bis 2017 war sechsmal so viel Arbeit hineingeflossen wie geplant, die Sammlung umfasste rund 24,5 Millionen Regeln und Aussagen, und fertig war sie nicht. Lenat arbeitete bis zu seinem Tod 2023 daran.
Ende der achtziger Jahre brach das Geschäft ein. Der größte Hersteller der Spezialrechner setzte 1986 gut 100 Millionen Dollar um, zwei Jahre später nur noch gut die Hälfte, 1993 war er insolvent. Gewöhnliche Arbeitsplatzrechner erledigten dieselbe Arbeit inzwischen fast so schnell und kosteten einen Bruchteil.
Was ein Mensch über die Welt weiß, ließ sich nicht in Regeln fassen. Jede Regel brauchte weitere Regeln, damit sie überhaupt verständlich wurde. Wenn eine Maschine je verstehen sollte, wovon sie redet, musste sie es sich selbst beibringen. Wie man eine solche Maschine baut, wusste damals niemand.
Rückwärts rechnen
Dabei lag ein Verfahren dafür seit 1970 vor. Es hatte nur kaum jemand bemerkt. Um zu sehen, was es leistet, muss man wissen, was das Üben bei einem Netz mit mehreren Schichten so schwierig macht.
Ein solches Netz besteht aus sehr vielen Schaltern, die in Schichten hintereinanderliegen. Vorne geht ein Foto hinein, hinten kommt eine Antwort heraus. Man zeigt ihm ein Foto, von dem man weiß, dass eine Katze darauf ist, und es antwortet: Hund. Jetzt muss sich etwas ändern, nur was? An der falschen Antwort sind nicht ein oder zwei Schalter schuld. Alle haben dazu beigetragen, jeder ein bisschen. Sie einzeln durchzuprobieren ist unmöglich, dafür sind es zu viele.
Der Ausweg ist, rückwärts zu rechnen. Man fängt bei der falschen Antwort an und geht Schicht für Schicht zurück durch das Netz. So lässt sich für jeden Schalter ausrechnen, wie viel er zu dem Fehler beigetragen hat, und bei jedem werden die Verbindungen ein winziges Stück nachgestellt.
Es ist wie bei einer Nachricht, die durch viele Hände gegangen und am Ende falsch angekommen ist. Man fragt den Letzten, was er bekommen hat, dann dessen Vorgänger, und so weiter bis zum Anfang. Danach weiß man von jedem, wie viel er verfälscht hat, und ein einziger Durchgang genügt dafür.
Dann kommt das nächste Bild, und das nächste, millionenfach. Irgendwann erkennt das Netz Katzen. Dabei hat ihm nie jemand gesagt, woran man eine erkennt. Fachleute nennen dieses Üben Training.
Aufgeschrieben hat das Rückwärtsrechnen 1970 ein finnischer Student in seiner Diplomarbeit. Seppo Linnainmaa ging es um etwas ganz anderes. Er wollte wissen, wie sich kleine Ungenauigkeiten durch eine lange Rechnung fortpflanzen. Von Netzen, vom Lernen und von künstlicher Intelligenz steht in seiner Arbeit kein Wort. Der Amerikaner Paul Werbos leitete das Verfahren 1974 in seiner Doktorarbeit erneut her, diesmal für lernende Systeme. Auch das blieb liegen.

Unabhängig davon beschrieb der japanische Ingenieur Kunihiko Fukushima 1980 eine Bauweise für Netze, die Bilder verarbeiten. Er orientierte sich am Sehen von Tieren. Die erste Schicht seines Netzes findet Kanten und Ecken, die nächste setzt daraus Formen zusammen, die übernächste ganze Gegenstände. Vom Rückwärtsrechnen wusste Fukushima nichts.
1986 zeigten drei Forscher in der Zeitschrift Nature, dass sich Netze mit mehreren Schichten durch Rückwärtsrechnen tatsächlich üben lassen. Das war genau das, was Minsky und Papert für aussichtslos gehalten hatten. Einer der drei war der Brite Geoffrey Hinton.
Der französische Informatiker Yann LeCun verband kurz darauf bei den Bell Laboratories, dem Forschungslabor der amerikanischen Telefongesellschaft, Fukushimas Bauweise mit dem Rückwärtsrechnen. Seine Netze lasen handgeschriebene Ziffern, und ab 1996 lasen sie bei mehreren amerikanischen Banken die Beträge auf Schecks.

Ein Durchbruch war das trotzdem nicht. Andere Rechenverfahren, die mit Netzen nichts zu tun hatten, lasen Ziffern genauso gut, waren mathematisch besser verstanden und mussten nicht wochenlang üben. Und Netze mit vielen Schichten hatten ein eigenes Problem, das 1991 ein Student in München benannte. Sepp Hochreiter zeigte in seiner Diplomarbeit, dass die Korrektur beim Rückwärtsrechnen von Schicht zu Schicht schwächer wird, bis bei den vorderen Schichten nichts mehr ankommt. Wer in diesen Jahren über neuronale Netze forschte, tat es gegen den Strom.
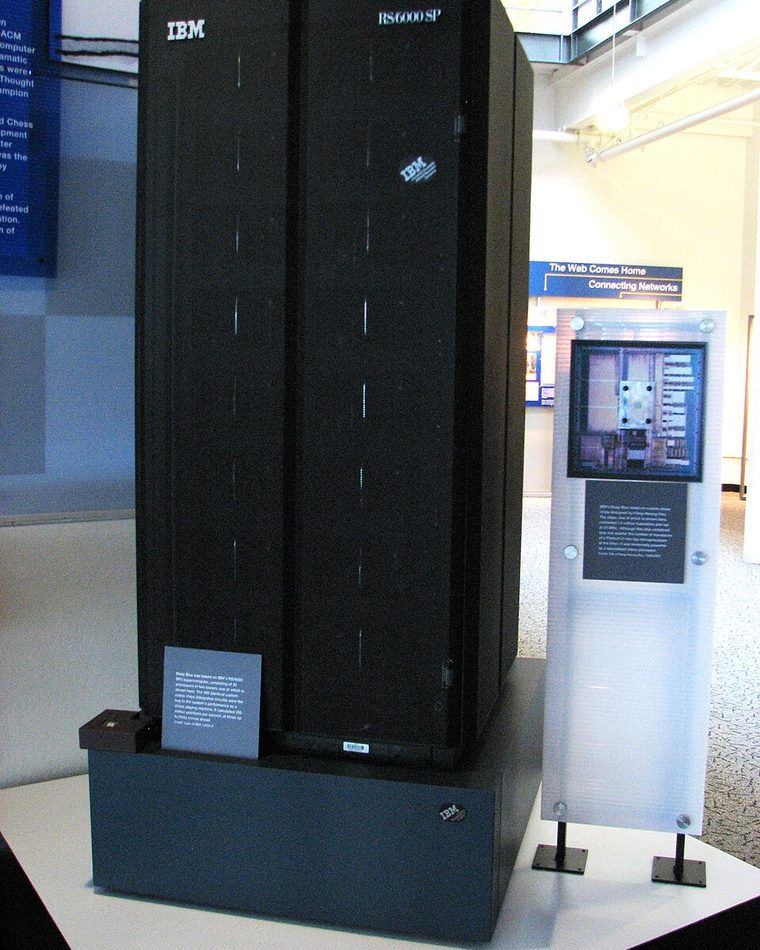
Am meisten Aufsehen erregte in diesem Jahrzehnt eine Maschine, die gar nichts lernte. Im Mai 1997 schlug der Schachcomputer Deep Blue von IBM in New York den Weltmeister Garri Kasparow mit dreieinhalb zu zweieinhalb Punkten. Ein Jahr zuvor hatte Kasparow noch gewonnen. Deep Blue durchsuchte bis zu 200 Millionen Stellungen in der Sekunde und bewertete jede nach Regeln, die Schachgroßmeister ihm mitgegeben hatten. Das war von Hand eingebautes Wissen, verbunden mit sehr viel Rechenkraft. Auf andere Aufgaben ließ sich diese Bauweise nicht übertragen, und nach dem Wettkampf schaltete IBM die Maschine ab.
Bilder und Grafikkarten

Zum Üben braucht ein Netz Millionen Beispiele, und bei jedem muss dabeistehen, was darauf zu sehen ist. Genau daran fehlte es. 2007 begann die Informatikerin Fei-Fei Li, diese Lücke zu schließen. Sie sammelte Fotos aus dem Internet ein, mehr als 160 Millionen, aus denen die brauchbaren herausgesucht und benannt werden mussten. Das konnte nur von Hand geschehen, Bild für Bild: Katze, Stuhl, Schiff, Kirche.
Li nutzte dafür eine Plattform von Amazon, auf der jeder gegen kleines Geld einfache Aufträge übernehmen kann. Zwischen 2008 und 2010 haben 49.000 Menschen aus 167 Ländern die Bilder durchgesehen. Die Sammlung hieß ImageNet. Als Li sie 2009 auf einer Fachtagung vorstellte, bekam sie dafür nach eigener Erinnerung keinen Vortrag. Sie durfte ein Plakat aufhängen.
Es gab noch einen zweiten Weg, an solche Daten zu kommen, und an ihm haben die meisten Menschen selbst mitgearbeitet. Die kleinen Tests im Internet, bei denen man verzerrte Buchstaben abtippt oder Bilder mit Ampeln anklickt, prüfen, ob am anderen Ende ein Mensch sitzt. Sie sind zugleich Arbeit. Zuerst half das Abtippen, alte Bücher und Zeitungsjahrgänge zu erfassen. Ab 2012 zeigten die Tests Ausschnitte aus Straßenaufnahmen, Hausnummern und Schilder, und jede Antwort lieferte ein weiteres benanntes Beispiel.
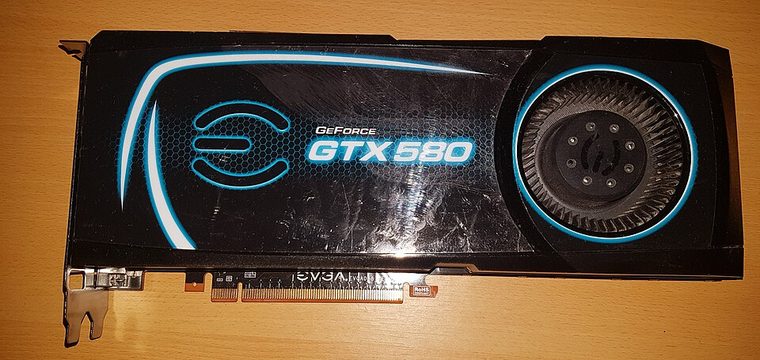

Es fehlte noch die Rechenkraft. Sie kam von Grafikkarten für Computerspiele. Beim Üben braucht jede Verbindung im Netz dieselbe kleine Rechnung, millionenfach bei jedem Bild. Eine Grafikkarte ist dafür gebaut, Millionen Bildpunkte gleichzeitig auszurechnen, und erledigt auch diese Rechnungen nebeneinander statt nacheinander. 2011 gewann eine Forschergruppe um den Informatiker Dan Cireşan mit Netzen auf Grafikkarten einen deutschen Wettbewerb im Erkennen von Verkehrszeichen und lag dabei vor den menschlichen Testpersonen. Verkehrszeichen waren allerdings eine kleine Aufgabe, und außerhalb des Fachs nahm kaum jemand davon Notiz.
Die große Aufgabe war ImageNet. Dazu gab es ab 2010 jedes Jahr einen Wettbewerb. Ein Programm bekam ein Foto und sollte sagen, was darauf zu sehen ist. 2012 trat ein Team aus Toronto an. Es bestand aus Geoffrey Hinton, einem der drei von 1986, und seinen Studenten Alex Krizhevsky und Ilya Sutskever. Sie trainierten ihr Netz fünf bis sechs Tage lang auf zwei handelsüblichen Grafikkarten, mit 1,2 Millionen Bildern aus der Sammlung.
Jedes Programm durfte zu einem Foto fünf Vermutungen abgeben. Beim Netz aus Toronto war die richtige Antwort in 15 Prozent der Fälle nicht darunter, beim zweitbesten Programm in 26 Prozent. Die Bauweise des Netzes stammte von Fukushima und LeCun, das Rückwärtsrechnen von 1970. Neu waren vor allem die Bilder und die Grafikkarten, dazu eine einfachere Rechenvorschrift für die Schalter, mit der die Korrektur auch bei vielen Schichten vorne noch ankam. Die Sieger schrieben selbst in ihre Arbeit, für bessere Ergebnisse müsse man nur auf schnellere Grafikkarten und mehr Bilder warten. Danach stellte die Bilderkennung auf neuronale Netze um. Wie eine solche Bilderkennung von innen aussieht, zeigt die Seite „Bilderkennung zum Selbermachen“.
Zug 37 und acht Autoren
Im März 2016 trat in Seoul ein Programm namens AlphaGo gegen Lee Sedol an, einen der besten Go-Spieler der Welt. Go ist ein Brettspiel mit mehr möglichen Stellungen, als es Atome im Universum gibt. Durchrechnen wie Schach kann man es nicht. AlphaGo, gebaut von der Londoner Firma DeepMind, hatte aus Partien von Menschen gelernt und dann Millionen Partien gegen sich selbst gespielt.

In der zweiten Partie setzte das Programm mit seinem 37. Zug einen Stein an eine Stelle, an die kein Mensch ihn setzt. Es hatte selbst ausgerechnet, wie wahrscheinlich ein Mensch an dieser Stelle so zieht, und war auf eins zu zehntausend gekommen. Es zog trotzdem so, weil es seine Gewinnaussichten damit am höchsten einschätzte. Einer der Kommentatoren hielt den Zug für einen Fehler. Lee Sedol verließ den Raum und brauchte danach für seine Antwort fast eine Viertelstunde. Er verlor die Partie und den Wettkampf mit eins zu vier. 2019 beendete er seine Laufbahn. Auch als Nummer eins unter den Menschen, sagte er, stehe er nicht mehr an der Spitze, denn es gebe jetzt etwas, das niemand schlagen könne. Wie ein Programm im Spiel gegen sich selbst besser wird, zeigt die Seite „Der einzige gewinnende Zug“.
2017 erschien die Arbeit, auf der die heutigen Sprachprogramme beruhen. Sie handelte von maschineller Übersetzung, und geschrieben hatten sie acht Forscher bei Google. Bis dahin las ein Netz einen Satz so, wie man vorliest, ein Wort nach dem anderen, und jedes Wort musste auf das vorige warten. Das Netz der acht sieht alle Wörter eines Satzes auf einmal an und rechnet für jedes aus, welche anderen Wörter dafür wichtig sind. In dem Satz „Die Katze trank die Milch, weil sie Durst hatte“ muss es zum Beispiel herausfinden, dass mit „sie“ die Katze gemeint ist. Dieses Rechenverfahren gab es seit 2014, es heißt Aufmerksamkeit. Zunächst war es ein Zusatz zu den Netzen, die Wort für Wort lasen. Die acht ließen das Lesen Wort für Wort ganz weg. Weil in ihrem Netz kein Wort mehr auf das vorige warten muss, können viele Rechner gleichzeitig daran arbeiten. Damit warben die Autoren auch. Ihr Netz übersetzte besser als die Vorgänger und war nach dreieinhalb Tagen auf acht Grafikkarten fertig trainiert, zu einem Bruchteil der bisherigen Kosten. Die Bauweise heißt Transformer.
2018 baute die kalifornische Firma OpenAI daraus ein Netz, das nicht mehr übersetzte. Es setzte Texte fort. Ein solches Netz heißt Sprachmodell. Zum Üben braucht es niemanden, der Beispiele benennt. Man gibt ihm den Anfang eines Textes und lässt es das nächste Wort raten, und die richtige Antwort steht im Text schon da. Was es dabei lernt, kennt jeder von seinem Telefon. Man tippt eine Nachricht, und über der Tastatur erscheinen Vorschläge für das nächste Wort. Die Handytastatur berücksichtigt dabei die letzten paar Wörter. Die großen Sprachmodelle wurden mit einem erheblichen Teil des frei zugänglichen Internets gefüttert und behalten ganze Seiten im Blick. Wer oft genug das nächste Wort richtig trifft, schreibt irgendwann Sätze, dann Absätze, dann ganze Texte.
Wenn ein Sprachmodell rät, kommt kein fertiges Wort heraus. Heraus kommt eine Liste mit allen Wörtern, die als Nächstes kommen könnten, und für jedes eine Wahrscheinlichkeit. Welches Wort genommen wird, entscheidet ein Zufallsgenerator, bei dem wahrscheinliche Wörter öfter drankommen. Nähme man immer das wahrscheinlichste, würde der Text sich wiederholen und in Schleifen laufen. Wegen dieses Zufalls bekommt man auf dieselbe Frage nicht zweimal dieselbe Antwort. Genauer erklärt das die Seite „Wie ein Sprachmodell funktioniert“.
Die Modelle wurden von Jahr zu Jahr größer. Das dritte von OpenAI, im Mai 2020 vorgestellt, bestand aus 175 Milliarden einstellbaren Zahlen, den Stärken seiner Verbindungen. Eine Frage ist für ein solches Modell auch nur ein Textanfang. Es setzt ihn mit dem fort, was auf eine Frage am wahrscheinlichsten folgt, und das ist eine Antwort. Damit die Antworten brauchbar wurden, ließ die Firma Menschen sie bewerten, und das Modell lernte daraus, die besser bewerteten zu geben.

Am 30. November 2022 stellte OpenAI ein Textfeld ins Internet, in das jeder hineinschreiben konnte. Es hieß ChatGPT und war als Vorschau gedacht. Nach fünf Tagen hatten sich eine Million Menschen angemeldet. Das Programm dahinter gab es im Kern schon. Geändert hatte sich, dass man mit ihm reden konnte und dass es nichts kostete.
Die Anerkennung folgte 2024. Der Nobelpreis für Physik ging an Geoffrey Hinton und den amerikanischen Physiker John Hopfield, für Arbeiten an neuronalen Netzen aus den achtziger Jahren. Den Preis für Chemie erhielten einen Tag später unter anderen zwei Forscher von DeepMind. Ihr Programm AlphaFold sagt vorher, welche räumliche Gestalt ein Eiweiß annimmt.
Was es mit uns macht
Nach einer Umfrage des Digitalverbands Bitkom vom Frühjahr 2026 nutzen in Deutschland 58 Prozent der Menschen ab sechzehn künstliche Intelligenz, jeder Dritte mindestens einmal in der Woche. 44 Prozent sagen zugleich, ihnen fehle das Vertrauen. Bei Jugendlichen gehört KI zum Schulalltag. Nach der JIM-Studie von 2025, einer jährlichen Befragung zum Medienalltag von Jugendlichen, benutzen drei von vier Zwölf- bis Neunzehnjährigen sie für Hausaufgaben und zum Lernen, und mehr als die Hälfte hält für vertrauenswürdig, was die KI liefert.
Eine britische Erhebung von 2025 hat Kinder und Jugendliche zwischen neun und siebzehn gefragt, wie sich das Gespräch mit einem Chatbot anfühlt. Ein Drittel beschreibt es als Gespräch mit einem Freund. Bei Kindern, die als besonders verletzlich gelten, ist es die Hälfte. Zwölf Prozent sagen, sie reden mit einem Programm, weil sie sonst niemanden haben.
Weizenbaums Sekretärin wusste, dass sie mit einem Programm aus ein paar tausend Zeilen sprach. Sie bat trotzdem darum, allein gelassen zu werden. Für das, was dabei mit Menschen geschieht, gibt es inzwischen einen Namen, den Eliza-Effekt.
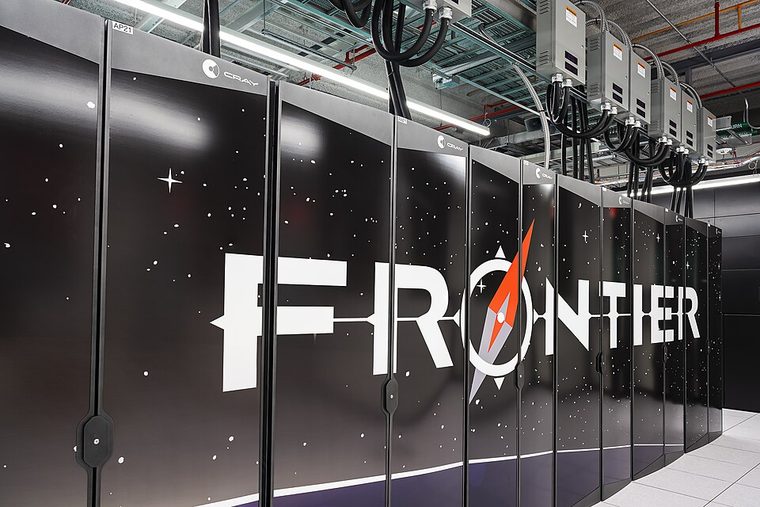

Die Technik liegt in wenigen Händen. Alle diese Programme brauchen riesige Rechenzentren, und die stehen fast nur in zwei Ländern. Von der Rechenleistung der 500 stärksten Anlagen der Welt entfallen nach einem Bericht der Vereinten Nationen 75 Prozent auf die Vereinigten Staaten und 15 Prozent auf China. Fast alle Chips dafür kommen von einem einzigen Hersteller in Taiwan. Davon handelt der Film „Die Fabrik der Welt“.
Dieselbe Technik, die Katzen auf Fotos erkennt, kann auch Ziele auswählen. Seit Oktober 2023 fordern der Generalsekretär der Vereinten Nationen und die Präsidentin des Internationalen Komitees vom Roten Kreuz gemeinsam einen verbindlichen Vertrag über Waffen, die selbst entscheiden, wen sie angreifen. Fertig sein sollte er 2026. Am 5. September 2026 einigten sich in Genf 128 Staaten auf ein Papier, das rechtlich nicht bindet. In den letzten Stunden wurde es noch abgeschwächt, nach Angaben der Nachrichtenagentur Reuters auf Druck der Vereinigten Staaten und Russlands. Über einen verbindlichen Vertrag wird bis heute nicht verhandelt.
Wovon sie redet
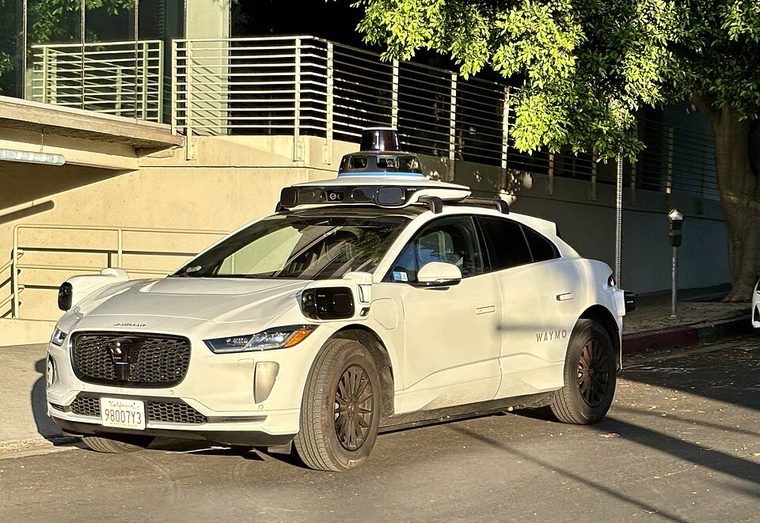

Seit 2023 steuern Netze derselben Bauart wie die Sprachmodelle auch Roboter. Roboter sollen greifen, aufräumen und fahren. Das Fahren klappt inzwischen. Ein einziger Anbieter hat nach eigenen Angaben mehr als 350 Millionen Kilometer ohne Fahrer zurückgelegt. Auch Roboter auf zwei Beinen gibt es zu kaufen, ein chinesischer Hersteller lieferte 2025 nach eigenen Angaben mehr als 5.500 Stück aus. Das Greifen mit einer künstlichen Hand ist bis heute nicht gelöst. Warum es so schwer ist, zeigt die Seite „Hand und Auge“.
Mit den Robotern kehrt eine ältere Frage zurück. Kann eine Maschine verstehen, wovon sie redet, wenn sie nie etwas angefasst, gesehen oder geschmeckt hat? Alles, was ein Sprachmodell kennt, kennt es aus Texten. In allen Büchern der Welt steht, dass eine Zitrone sauer ist. Was sauer bedeutet, steht dort nicht. Dort steht, dass es das Gegenteil von süß ist, und was süß bedeutet, steht auch nicht dort. Wer nie etwas geschmeckt hat, kann alles über Zitronen lesen und weiß am Ende trotzdem nicht, wie sie schmecken.
Seit 1990 hat dieser Einwand einen Namen. Der Kognitionsforscher Stevan Harnad nannte ihn das Erdungsproblem. Irgendwo muss die Kette der Erklärungen in etwas münden, das kein Wort mehr ist. Douglas Lenat hatte mit seinen Regeln über Wasser und Gläser etwas Ähnliches erlebt. Jede seiner Regeln erklärte Wörter nur durch weitere Wörter.
Zum Vergleich: Ein Hund nimmt die Welt, wie wir, mit weit mehr als fünf Sinnen wahr. In der Schule lernt man fünf, nämlich Sehen, Hören, Riechen, Schmecken und Tasten. Dazu kommen aber eigene Sinne für Wärme und Kälte, für Schmerz, für das Gleichgewicht und für die Lage des eigenen Körpers, und je feiner man unterteilt, desto mehr werden es. Ein Hund riecht, wer vor einer Stunde hier war, und hört Töne, die wir nicht hören. Ein Sprachmodell bekommt eine Folge von Zeichen. Ob das für Verstehen genügt, ist unter Fachleuten umstritten. Harnad blieb 2024 bei seinem Einwand. Eine im selben Jahr erschienene Arbeit hält ihn bei Sprachmodellen für nicht anwendbar.
Alan Turing hatte 1948 eine Maschine beschrieben, die durch Erfahrung lernt, durch Belohnung und Bestrafung. Sein Direktor legte den Bericht weg. 78 Jahre später fängt die Forschung dort wieder an. Roboter lernen das Greifen und Laufen heute auf diese Weise, durch Versuch, Belohnung und Bestrafung.
Woher die Angaben stammen
Zur Nervenzelle von 1943, zu Hebb und zu Turing. Warren S. McCulloch und Walter Pitts, A Logical Calculus of the Ideas Immanent in Nervous Activity, Bulletin of Mathematical Biophysics 5, 1943. Zu Pitts’ Lebensweg Neil R. Smalheiser, Walter Pitts, Perspectives in Biology and Medicine 43, 2000. Alan M. Turing, Intelligent Machinery, Bericht für das National Physical Laboratory, 1948. B. Jack Copeland, Turing, Father of the Modern Computer, The Rutherford Journal 4, 2011. Zu Hebbs Lernregel von 1949 Richard E. Brown, Thaddeus W. B. Bligh und Jessica F. Garden, The Hebb Synapse Before Hebb, Frontiers in Behavioral Neuroscience 15, 2021. Alan M. Turing, Computing Machinery and Intelligence, Mind LIX, 1950.
Zum Sommer in Dartmouth. J. McCarthy, M. L. Minsky, N. Rochester und C. E. Shannon, A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence, 31. August 1955. Zur Bewilligung durch die Stiftung Barbara Shubinski, „A Roomful of Brains“. Early Advances in Computer Science and Artificial Intelligence, Rockefeller Archive Center, 2013. Zum Verlauf des Treffens, zu Ray Solomonoffs Notizbuch und zu McCarthys Rückblick Grace Solomonoff, Ray Solomonoff and the Dartmouth Summer Research Project in Artificial Intelligence, 1956, Oxbridge Research, ohne Jahr. Zur Wahl des Namens John McCarthy, Besprechung des Bandes The Question of Artificial Intelligence, 1988. Zu Solomonoffs Werdegang Peter Gács und Paul M. B. Vitányi, Raymond J. Solomonoff 1926–2009, Nachruf, 2011.
Zum Perceptron und zu Minsky und Papert. The New York Times, New Navy Device Learns By Doing, 8. Juli 1958. Frank Rosenblatt, The Perceptron. A Perceiving and Recognizing Automaton, Report 85-460-1, Cornell Aeronautical Laboratory, Januar 1957. Melanie Lefkowitz, Professor’s perceptron paved the way for AI – 60 years too soon, Cornell Chronicle, September 2019. Zum Aufbau des Geräts der Wikipedia-Eintrag „Mark I Perceptron“, zu den Beweisen von 1969 der Wikipedia-Eintrag „Perceptrons (book)“, beide abgerufen im September 2026. Zum Urteil über die mehrschichtige Fassung Quote Investigator, Our Intuitive Judgment That the Extension Is Sterile, Juli 2026. Zur Aufnahme des Buchs in der Fachwelt Mikel Olazaran, A Sociological Study of the Official History of the Perceptrons Controversy, Social Studies of Science 26, 1996. Nachruf der Cornell University auf Frank Rosenblatt, 1971. Frank Rosenblatt, The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain, Psychological Review 65, 1958. Frank Rosenblatt, Principles of Neurodynamics. Perceptrons and the Theory of Brain Mechanisms, Cornell Aeronautical Laboratory, 1961.
Zu ELIZA. Joseph Weizenbaum, ELIZA. A Computer Program For the Study of Natural Language Communication Between Man And Machine, Communications of the ACM 9, 1966. Zur Sekretärin, von der Weizenbaum 1976 in seinem Buch „Computer Power and Human Reason“ erzählt, ELIZA Archaeology Project, Weizenbaum’s Secretary. Zum Fund des Originals und zum ersten Lauf Rupert Lane, Anthony Hay, Arthur Schwarz, David M. Berry und Jeff Shrager, ELIZA Reanimated. The world’s first chatbot restored on the world’s first time sharing system, arXiv, 2025. Zu Weizenbaums Lebensdaten der Wikipedia-Eintrag „Joseph Weizenbaum“, abgerufen im September 2026.
Zum ausbleibenden Geld. ALPAC, Languages and Machines. Computers in Translation and Linguistics, National Academy of Sciences, 1966. John Hutchins, ALPAC: the (in)famous report, MT News International 14, 1996. James Lighthill, Artificial Intelligence. A General Survey, Science Research Council, 1973. Zur Fernsehdebatte das Videoarchiv des Artificial Intelligence Applications Institute der Universität Edinburgh, Lighthill Controversy Debate at the Royal Institution, 1973. Zum Labor in Edinburgh und zu den Mitgliederzahlen der Fachgruppe Thomas Haigh, There Was No „First AI Winter“, Communications of the ACM 66, 2023.
Zu den Expertensystemen und zu Cyc. Robert K. Lindsay, Bruce G. Buchanan, Edward A. Feigenbaum und Joshua Lederberg, DENDRAL. A case study of the first expert system for scientific hypothesis formation, Artificial Intelligence 61, 1993. Bruce G. Buchanan und Edward H. Shortliffe, Rule-Based Expert Systems. The MYCIN Experiments of the Stanford Heuristic Programming Project, 1984. Zum Vergleich mit den Medizinprofessoren und zum Einsatz in der Klinik Wikibooks, Expert Systems/MYCIN, abgerufen im September 2026. Zu XCON, Cyc und Douglas Lenat die Wikipedia-Einträge „Xcon“, „Cyc“ und „Douglas Lenat“, abgerufen im September 2026. Zum japanischen Programm Information Processing Society of Japan, Computer Museum, Start of the 5th Generation Computer Project for Knowledge-Based Information Processing. Zum Hersteller der Spezialrechner Alvin Graylin und andere, Symbolics, Inc. A failure of heterogeneous engineering, Fallstudie am Massachusetts Institute of Technology, 2001. John McDermott, R1: an Expert in the Computer Systems Domain, Proceedings of AAAI-80, 1980. Cade Metz, One Genius’ Lonely Crusade to Teach a Computer Common Sense, Wired, 2016. Kathy Panton u. a., Common Sense Reasoning – From Cyc to Intelligent Assistant, Springer, 2006.
Zum Rückwärtsrechnen und zu Deep Blue. Zu Seppo Linnainmaa Andreas Griewank, Who Invented the Reverse Mode of Differentiation?, Documenta Mathematica, 2012. Paul Werbos, Beyond Regression. New Tools for Prediction and Analysis in the Behavioral Sciences, Dissertation, Harvard, 1974. Kunihiko Fukushima, Neocognitron. A self-organizing neural network model, Biological Cybernetics 36, 1980. Rumelhart, Hinton und Williams, Learning representations by back-propagating errors, Nature 323, 1986. LeCun, Bottou, Bengio und Haffner, Gradient-Based Learning Applied to Document Recognition, Proceedings of the IEEE 86, 1998. Sepp Hochreiter, Untersuchungen zu dynamischen neuronalen Netzen, Diplomarbeit, TU München, 1991. Zu Deep Blue der Wikipedia-Eintrag „Deep Blue versus Garry Kasparov“, abgerufen im September 2026, und IBM, Deep Blue, Firmengeschichte. Yann Le Cun u. a., Handwritten Digit Recognition with a Back-Propagation Network, Advances in Neural Information Processing Systems 2, 1989.
Zu ImageNet und den Grafikkarten. Alex Krizhevsky, Ilya Sutskever und Geoffrey Hinton, ImageNet Classification with Deep Convolutional Neural Networks, NIPS 25, 2012. ImageNet, Stanford University, ILSVRC2012 Results, offizielle Ergebnisseite, 2012. Zur Entstehung der Sammlung der Wikipedia-Eintrag „ImageNet“, abgerufen im September 2026, und Dave Gershgorn, The data that transformed AI research—and possibly the world, Quartz, 2017. Cireşan, Meier, Masci und Schmidhuber, A Committee of Neural Networks for Traffic Sign Classification, IJCNN 2011. Hinton, Srivastava, Krizhevsky, Sutskever und Salakhutdinov, Improving neural networks by preventing co-adaptation of feature detectors, arXiv, 2012. Zu den Tests im Internet Luis von Ahn und Will Cathcart, Teaching computers to read: Google acquires reCAPTCHA, Official Google Blog, 2009. Sarah Perez, Google Now Using ReCAPTCHA To Decode Street View Addresses, TechCrunch, 2012. Google, reCAPTCHA: Creation of Value, Produktseite im Internet Archive, 2017. Xavier Glorot, Antoine Bordes und Yoshua Bengio, Deep Sparse Rectifier Neural Networks, Proceedings of Machine Learning Research 15, 2011.
Zu AlphaGo, zum Transformer und zu den Sprachmodellen. Cade Metz, In Two Moves, AlphaGo and Lee Sedol Redefined the Future, WIRED, 16. März 2016. ABC News Australia, Go grandmaster Lee Se-Dol retires saying artificial intelligence cannot be defeated, 29. November 2019. Vaswani, Shazeer, Parmar, Uszkoreit, Jones, Gomez, Kaiser und Polosukhin, Attention Is All You Need, arXiv, 2017. Brown und andere, Language Models are Few-Shot Learners, arXiv, 2020. Von OpenAI die Mitteilungen Improving Language Understanding with Unsupervised Learning, 2018, Aligning Language Models to Follow Instructions, 2022, und ChatGPT. Optimizing Language Models for Dialogue, 30. November 2022. Zur Zahl der Anmeldungen Sam Altman auf X, 5. Dezember 2022. Zur Auswahl des nächsten Wortes Holtzman, Buys, Du, Forbes und Choi, The Curious Case of Neural Text Degeneration, ICLR 2020. Königlich Schwedische Akademie der Wissenschaften, Pressemitteilungen zu den Nobelpreisen für Physik und für Chemie, 8. und 9. Oktober 2024. Demis Hassabis, AlphaGo: using machine learning to master the ancient game of Go, Google Blog, 2016. David Silver u. a., Mastering the game of Go with deep neural networks and tree search, Nature 529, 2016. Cade Metz, How Google’s AI Viewed the Move No Human Could Understand, Wired, 2016. OpenAI, Introducing ChatGPT, 2022. The Royal Swedish Academy of Sciences, Press release: The Nobel Prize in Chemistry 2024, 2024.
Zu Nutzung, Rechenzentren und autonomen Waffen. Bitkom, Ein Drittel nutzt KI mindestens einmal pro Woche, 28. April 2026. Medienpädagogischer Forschungsverbund Südwest, JIM-Studie 2025, 2025. Internet Matters, Me, myself and AI. Understanding and safeguarding children’s use of AI chatbots, 2025. Zum Namen Eliza-Effekt Eric S. Raymond (Hrsg.), The Jargon File, Eintrag „ELIZA effect“. Independent International Scientific Panel on AI der Vereinten Nationen, Preliminary Report, Juli 2026. Zur Chipfertigung Stanford HAI, The 2026 AI Index Report, 2026. Internationales Komitee vom Roten Kreuz und Vereinte Nationen, Joint call by the UN Secretary-General and the President of the ICRC, 5. Oktober 2023. Reuters, States Reach Agreement at Autonomous Weapons Talks in Geneva, 5. September 2026.
Zu Robotern und zum Erdungsproblem. Brohan und andere, RT-2. Vision-Language-Action Models Transfer Web Knowledge to Robotic Control, Google DeepMind, 2023. Waymo, Waymo Safety Impact, Datenstand März 2026. Unitree Robotics, Clarification Regarding Unitree’s 2025 Sales Data, 22. Januar 2026. Rodney Brooks, Why Today’s Humanoids Won’t Learn Dexterity, 2025. Stevan Harnad, The Symbol Grounding Problem, Physica D 42, 1990. Ders., Language Writ Large. LLMs, ChatGPT, Grounding, Meaning and Understanding, 2024. R. Gubelmann, Pragmatic Norms Are All You Need – Why The Symbol Grounding Problem Does Not Apply to LLMs, EMNLP 2024. Zum Lernen durch Belohnung Rudin, Hoeller, Reist und Hutter, Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning, CoRL 2021. Zu den Sinnen Barry Smith, Humans could have as many as 33 senses, The Conversation, 2025. Thomas Brandt u. a., Human senses and sensors from Aristotle to the present, Frontiers in Neurology 15, 2024.
Zur Recherche. Die Angaben beruhen auf einer eigenen Recherche mit rund 150 Quellen. Zahlen zur Gegenwart geben den Stand vom Sommer 2026 wieder.