Seoul, März 2016
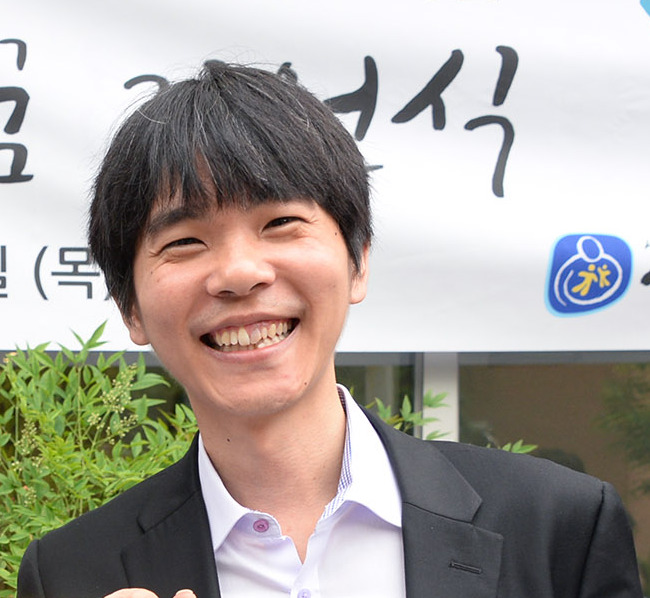
Im Hotel Four Seasons in Seoul setzte sich am 9. März 2016 der Südkoreaner Lee Sedol an ein Go-Brett. Er war 33 Jahre alt und achtzehnfacher Weltmeister. Sein Gegner hieß AlphaGo und war ein Programm der Londoner Firma DeepMind, die zu Google gehört. Lee Sedol gegenüber saß ein Mitarbeiter der Firma. Er setzte die Steine so, wie das Programm es auf einem Bildschirm vorgab.
Fünf Partien waren angesetzt. Lee Sedol rechnete damit, alle fünf zu gewinnen oder höchstens eine abzugeben. Im Schach hatte der Rechner Deep Blue schon 1997 den Weltmeister Garri Kasparow geschlagen. Bei Go waren die besten Menschen den Programmen noch weit voraus. Fachleute hatten kurz zuvor geschätzt, ein Programm werde die besten Go-Spieler frühestens in zehn Jahren schlagen.
Ein Spiel mit wenigen Regeln
Go spielt man mit schwarzen und weißen Steinen auf einem Gitter aus neunzehn mal neunzehn Linien. Die beiden Spieler setzen abwechselnd einen Stein auf einen Kreuzungspunkt. Anders als Schachfiguren werden die Steine danach nicht mehr bewegt.
Jeder Stein hat bis zu vier Nachbarpunkte, die über eine Linie an ihn angrenzen. Hat der Gegner sie alle besetzt, wird der Stein vom Brett genommen. Am Ende gewinnt, wer mehr vom Brett für sich hat. Dazu zählen die eigenen Steine und die leeren Punkte, die man mit ihnen eingezäunt hat.
Für Computer war dieses Spiel mit so wenigen Regeln viel schwerer als Schach. Beim Schach hat ein Spieler in jeder Stellung im Schnitt etwa 35 Züge zur Wahl. Bei Go sind es etwa 250, und auf jeden davon hat der Gegner wieder etwa 250 Antworten.
Schachcomputer waren stark geworden, indem sie sehr viele Fortsetzungen durchrechneten. Bei Go gibt es schon nach wenigen Zügen so viele Möglichkeiten, dass auch der schnellste Rechner nur einen winzigen Teil davon ansehen kann. Das Programm von DeepMind rechnete deshalb weniger und hatte dafür gelernt, welche Züge sich überhaupt zu prüfen lohnen.
Die dritte und die vierte Linie
Am Rand gewinnt man bei Go am leichtesten Gebiet. Wer mitten auf dem Brett ein Stück einzäunen will, braucht Steine auf allen vier Seiten. Am Rand ersetzt die Brettkante eine Seite des Zauns, in der Ecke sogar zwei. Deshalb beginnen beide Spieler in den Ecken und arbeiten sich an den Rändern entlang.
Sie setzen ihre Steine dabei einige Linien vor die Kante, nach einer alten Faustregel. Ein Stein auf der dritten Linie, vom Rand aus gezählt, sichert das Gebiet zwischen sich und der Kante. Dort ist zu wenig Platz, als dass sich der Gegner noch festsetzen könnte. Ein Stein auf der vierten Linie sichert am Rand weniger und hilft dafür später beim Kampf um die Brettmitte.
Nach dieser Lehre greift man einen gegnerischen Stein auf der vierten Linie nicht von der Brettmitte her an. Wer es tut, lädt den Gegner ein, sich unter dem Angreifer am Rand entlang auszubreiten, und schenkt ihm dort das Gebiet. Ein Partiekommentar nennt einen solchen Zug für Profis „früher undenkbar“.
Der 37. Zug
Die erste Partie hatte Lee Sedol verloren. Am 10. März begann die zweite. AlphaGo hatte die schwarzen Steine und fing an, Lee Sedol spielte Weiß. Nach knapp einer Stunde hatten beide zusammen 36 Steine gesetzt, und der größte Teil des Bretts war noch frei.
Lee Sedol hatte gerade einen weißen Stein nahe am rechten Rand gesetzt, auf die vierte Linie.
Sie haben Schwarz. Wohin würden Sie setzen? Tippen Sie auf einen freien Kreuzungspunkt.
Mit dem 37. Zug der Partie ließ AlphaGo seinen Stein schräg neben den weißen setzen, eine Linie weiter zur Mitte hin, auf die fünfte. Das war der Angriff von der Mitte her, den die Lehre verbietet.
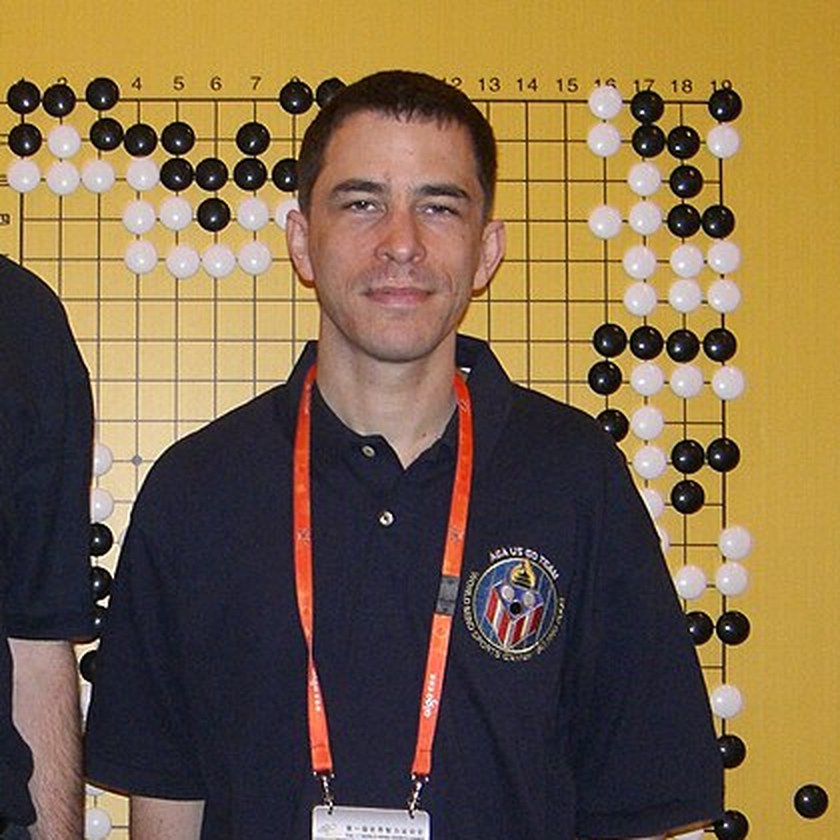
Den englischen Kommentar der Übertragung im Internet sprach Michael Redmond, ein Go-Profi mit dem höchsten Rang, zusammen mit Chris Garlock vom amerikanischen Go-Verband. Als der Stein lag, sagte Redmond: „Das ist ein sehr überraschender Zug.“ Garlock sagte: „Ich dachte, das sei ein Fehler.“ So gibt es der Reporter Cade Metz wieder, der für die Zeitschrift Wired im Saal saß. In der Übertragung ist zu hören, an welchen Fehler die beiden dachten. Gleich darauf fällt das Wort „Clicko“. So nennen Go-Spieler im Internet einen Stein, der durch einen falschen Klick an der falschen Stelle landet.
Lee Sedol brauchte fast eine Viertelstunde, bis er antwortete. Für die ganze Partie hatte jeder Spieler zwei Stunden Bedenkzeit.
War es ein Fehler?
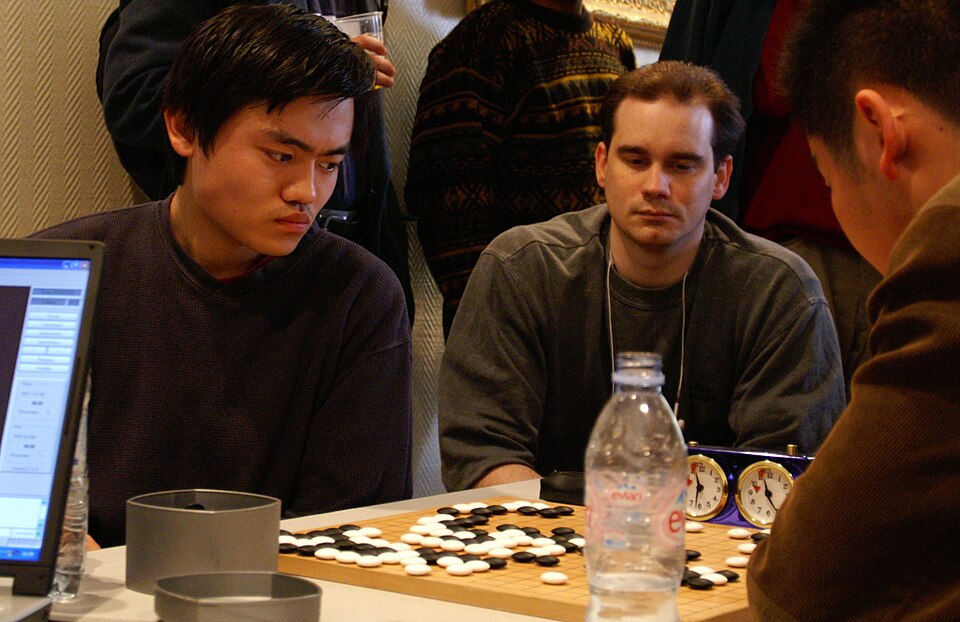
Fan Hui, dreifacher Europameister, saß in Seoul im Saal. Fünf Monate zuvor hatte er hinter verschlossenen Türen selbst gegen AlphaGo gespielt und alle fünf Partien verloren. Seitdem hatte er oft gegen das Programm gespielt. Als der Stein lag, wusste er zuerst nicht, was er davon halten sollte. Nach etwa zehn Sekunden sah er, wie der Stein mit den achtzehn anderen schwarzen Steinen zusammenspielte. Zu Cade Metz sagte er: „Das ist kein menschlicher Zug. Ich habe nie einen Menschen so spielen sehen.“ Und dann: „So schön. So schön.“
Michael Redmond ging die Partie Jahre später für den amerikanischen Go-Verband noch einmal durch. Ein solcher Zug auf der fünften Linie, sagte er dort sinngemäß, sei beinahe ein Tabu, weil er dem Gegner zu viel Gebiet lasse. Zusammen mit den anderen schwarzen Steinen sehe er aber aus wie ein Plan. Während der Übertragung habe er das nicht durchschaut.
Ein Partiekommentar beschreibt den Plan so: AlphaGo hatte gar nicht vor, am rechten Rand Gebiet zu machen. Es überließ den Rand Weiß und baute dafür mit diesem und zwei früheren Steinen an einer starken Stellung zur Brettmitte hin. Solche Steine bringen zunächst kein Gebiet. Sie helfen aber in den Kämpfen, die später kommen.
Weder Fan Hui noch Redmond hielt den Zug am Ende für einen Fehler. Dass es der beste Zug war, hat damit niemand bewiesen. AlphaGo gewann die Partie gut 170 Züge später. Lee Sedol sagte danach vor der Presse: „Gestern war ich überrascht. Heute bin ich sprachlos.“
Warum AlphaGo so setzte
Zuerst bekam AlphaGo dreißig Millionen Züge aus Partien starker menschlicher Spieler zu sehen. Daran lernte es einzuschätzen, was ein Mensch an einer bestimmten Stelle spielen würde. Das ist seine erste Einschätzung. Sie sagt, was üblich ist.
Danach spielte es Millionen Partien gegen sich selbst und hielt fest, aus welchen Stellungen heraus öfter gewonnen wurde. Daraus entstand eine zweite Einschätzung. Sie sagt, wie gut eine Stellung für einen Spieler steht, also was gewinnt.
In einer Partie rechnet AlphaGo voraus, sieht sich aber nur wenige, ausgewählte Fortsetzungen an. Die erste Einschätzung bestimmt, welche Züge es gründlich durchrechnet und welche nur kurz. Mit der zweiten bewertet es die Stellungen, die dabei entstehen. Züge, die Menschen selten spielen, fallen nicht ganz heraus. Sie bekommen nur weniger Rechenzeit.
Nach der zweiten Partie sah David Silver, der Leiter des AlphaGo-Projekts, in den Daten des Programms nach. Die erste Einschätzung hatte dem 37. Zug kaum eine Chance gegeben: Ein Mensch würde ihn nur mit einer Wahrscheinlichkeit von eins zu zehntausend spielen. Beim Vorausrechnen prüfte das Programm ihn trotzdem, und die zweite Einschätzung fiel günstig aus. Silver sagte dazu, das Programm habe diesen Zug selbst entdeckt.
Beim 37. Zug widersprach sich, was üblich ist und was gewinnt, und das Programm hielt sich an das, was gewinnt.
Die Zahl eins zu zehntausend und diese Erklärung stammen von DeepMind selbst. Stimmt die Erklärung, dann ging das Programm an dieser Stelle über seine menschlichen Vorbilder hinaus.
Der 78. Zug
Zwei Tage später verlor Lee Sedol auch die dritte Partie. Damit war der Wettkampf entschieden, die beiden übrigen Partien wurden trotzdem gespielt.
In der vierten, am 13. März, stand Lee Sedol zur Mitte der Partie schlecht. Dann dachte er eine halbe Stunde über einen einzigen Zug nach und setzte einen weißen Stein in die Brettmitte, als Keil zwischen die Steine von AlphaGo. Es war der 78. Zug der Partie. Michael Redmond, der wieder kommentierte, nannte ihn brillant.
AlphaGo antwortete mit einem schwachen Zug. Wenige Minuten später erkannte das Programm, dass seine Aussicht auf den Sieg eingebrochen war. Es spielte noch rund hundert Züge weiter und gab dann auf.
Demis Hassabis, der Chef von DeepMind, sagte am nächsten Morgen, das Programm sei auf den Zug nicht vorbereitet gewesen, weil es nicht damit gerechnet habe, dass ein Mensch so spielt. Seine erste Einschätzung habe auch diesem Zug nur eins zu zehntausend gegeben.
Beim 37. Zug hatte das Programm die Menschen überrascht. Beim 78. war es umgekehrt. Naheliegend ist, dass die erste Einschätzung das Programm diesmal selbst in die Irre führte. Die knappe Rechenzeit für seltene Züge hatte beim eigenen 37. Zug gereicht, um seinen Wert zu erkennen. Bei Lee Sedols 78. reichte sie nicht.
Lee Sedol lachte, als er nach dieser Partie vor die Presse trat. Ihm sei noch nie so sehr gratuliert worden, nur weil er eine einzige Partie gewonnen habe, sagte er. Und dann: „Dieser eine Sieg ist so wertvoll, dass ich ihn gegen nichts auf der Welt tauschen würde.“
AlphaGo gewann auch die fünfte Partie. Am Ende stand es vier zu eins.
Was danach kam
Im Oktober 2017 stellte DeepMind einen Nachfolger vor, AlphaGo Zero. Die Null im Namen sagt, dass dieses Programm keine einzige menschliche Partie gesehen hatte. Es bekam die Regeln und spielte drei Tage lang gegen sich selbst, 4,9 Millionen Partien. Dann trat es gegen die Fassung an, die Lee Sedol geschlagen hatte, und gewann hundert zu null.
Lee Sedol beendete im November 2019 seine Laufbahn als Profi. Als einen Grund nannte er die Programme. Auch wenn er die Nummer eins werde, sagte er der Nachrichtenagentur Yonhap, gebe es nun etwas, das sich nicht besiegen lasse.
DeepMind baute danach ein lernendes Programm, das vorhersagt, welche Form ein Eiweiß annimmt. An dieser Frage hatte die Forschung fünfzig Jahre gearbeitet. Demis Hassabis und sein Kollege John Jumper erhielten dafür 2024 den Nobelpreis für Chemie.
ChatGPT und andere Sprachprogramme haben zuerst so gelernt wie AlphaGo in seinem ersten Schritt: an sehr vielen Texten, was Menschen üblicherweise schreiben. Danach bewerten Menschen ihre Antworten, und bei Aufgaben mit einem klaren Richtig oder Falsch, etwa beim Rechnen, zählt das Ergebnis. Für einen guten Text gibt es meist kein so einfaches Urteil wie Sieg oder Niederlage beim Go. Wie weit diese Programme über das hinauskommen, was Menschen geschrieben haben, lässt sich deshalb schwerer sagen.
Wie eine Maschine überhaupt aus Beispielen lernt, zeigt die Lerneinheit „So lernt eine Maschine“. Wie ein Programm allein durch Partien gegen sich selbst stark wird, können Sie bei „Der einzige gewinnende Zug“ an Vier gewinnt selbst beobachten.
Quellen
Cade Metz, Wired: „The Sadness and Beauty of Watching Google's AI Play Go“, 11.03.2016; „How Google's AI Viewed the Move No Human Could Understand“, 14.03.2016; „In Two Moves, AlphaGo and Lee Sedol Redefined the Future“, 16.03.2016.
David Silver u. a.: „Mastering the game of Go with deep neural networks and tree search“, Nature 529, 2016.
David Silver u. a.: „Mastering the game of Go without human knowledge“, Nature 550, 2017.
Partieaufzeichnungen der zweiten und vierten Partie; Partietabelle der englischen Wikipedia, „AlphaGo versus Lee Sedol“.
Google DeepMind: Originalübertragung der zweiten Partie, YouTube, 10.03.2016.
Michael Redmond: Rückschau auf die zweite Partie, American Go Association, YouTube.
„Invisible“, Partiekommentar zur zweiten Partie, Leseprobe des Nordic Go Dojo (nordicgodojo.eu).
British Go Journal Nr. 174; Sensei's Library, „High and low moves“; Deutscher Go-Bund, „Regeln“.
NPR und The Guardian, 13.03.2016; The Verge, 10.03.2016; BBC und Yonhap, 27.11.2019.
Königlich Schwedische Akademie der Wissenschaften, Pressemitteilung zum Nobelpreis für Chemie, 09.10.2024.